Node.js에서 텍스트 파일을 스트림으로 읽어 text += chunk로 이어 붙이면, 테스트용 작은 파일은 멀쩡한데 큰 파일에서만 한글 몇 글자가 U+FFFD(물음표가 든 마름모 �)로 바뀔 수 있습니다. 2026년 11월 9일 macOS 27.0.1의 Node.js v24.21.0에서 같은 한글 텍스트를 파일은 다섯 가지, 로컬 HTTP 응답은 세 가지 방법으로 읽어 보았습니다. 이 글을 읽고 나면 깨진 자리를 바이트로 찾고, 내 코드에 맞는 고치는 방법 하나를 고를 수 있습니다.
같은 코드인데 큰 파일에서만 깨졌다
예제 텍스트는 한 줄이 66바이트입니다. 네 자리 줄 번호, 공백, 한글 음절 20자, 줄바꿈입니다. 한글 음절은 UTF-8에서 한 글자가 3바이트라 20자가 60바이트를 차지합니다. 이 줄을 100줄 쓴 small.txt(6,600바이트)와 3,000줄 쓴 large.txt(198,000바이트)를 만들고 아래처럼 읽었습니다.
import fs from 'node:fs';

let text = '';
for await (const chunk of fs.createReadStream('large.txt')) {
  text += chunk; // chunk is a Buffer
}
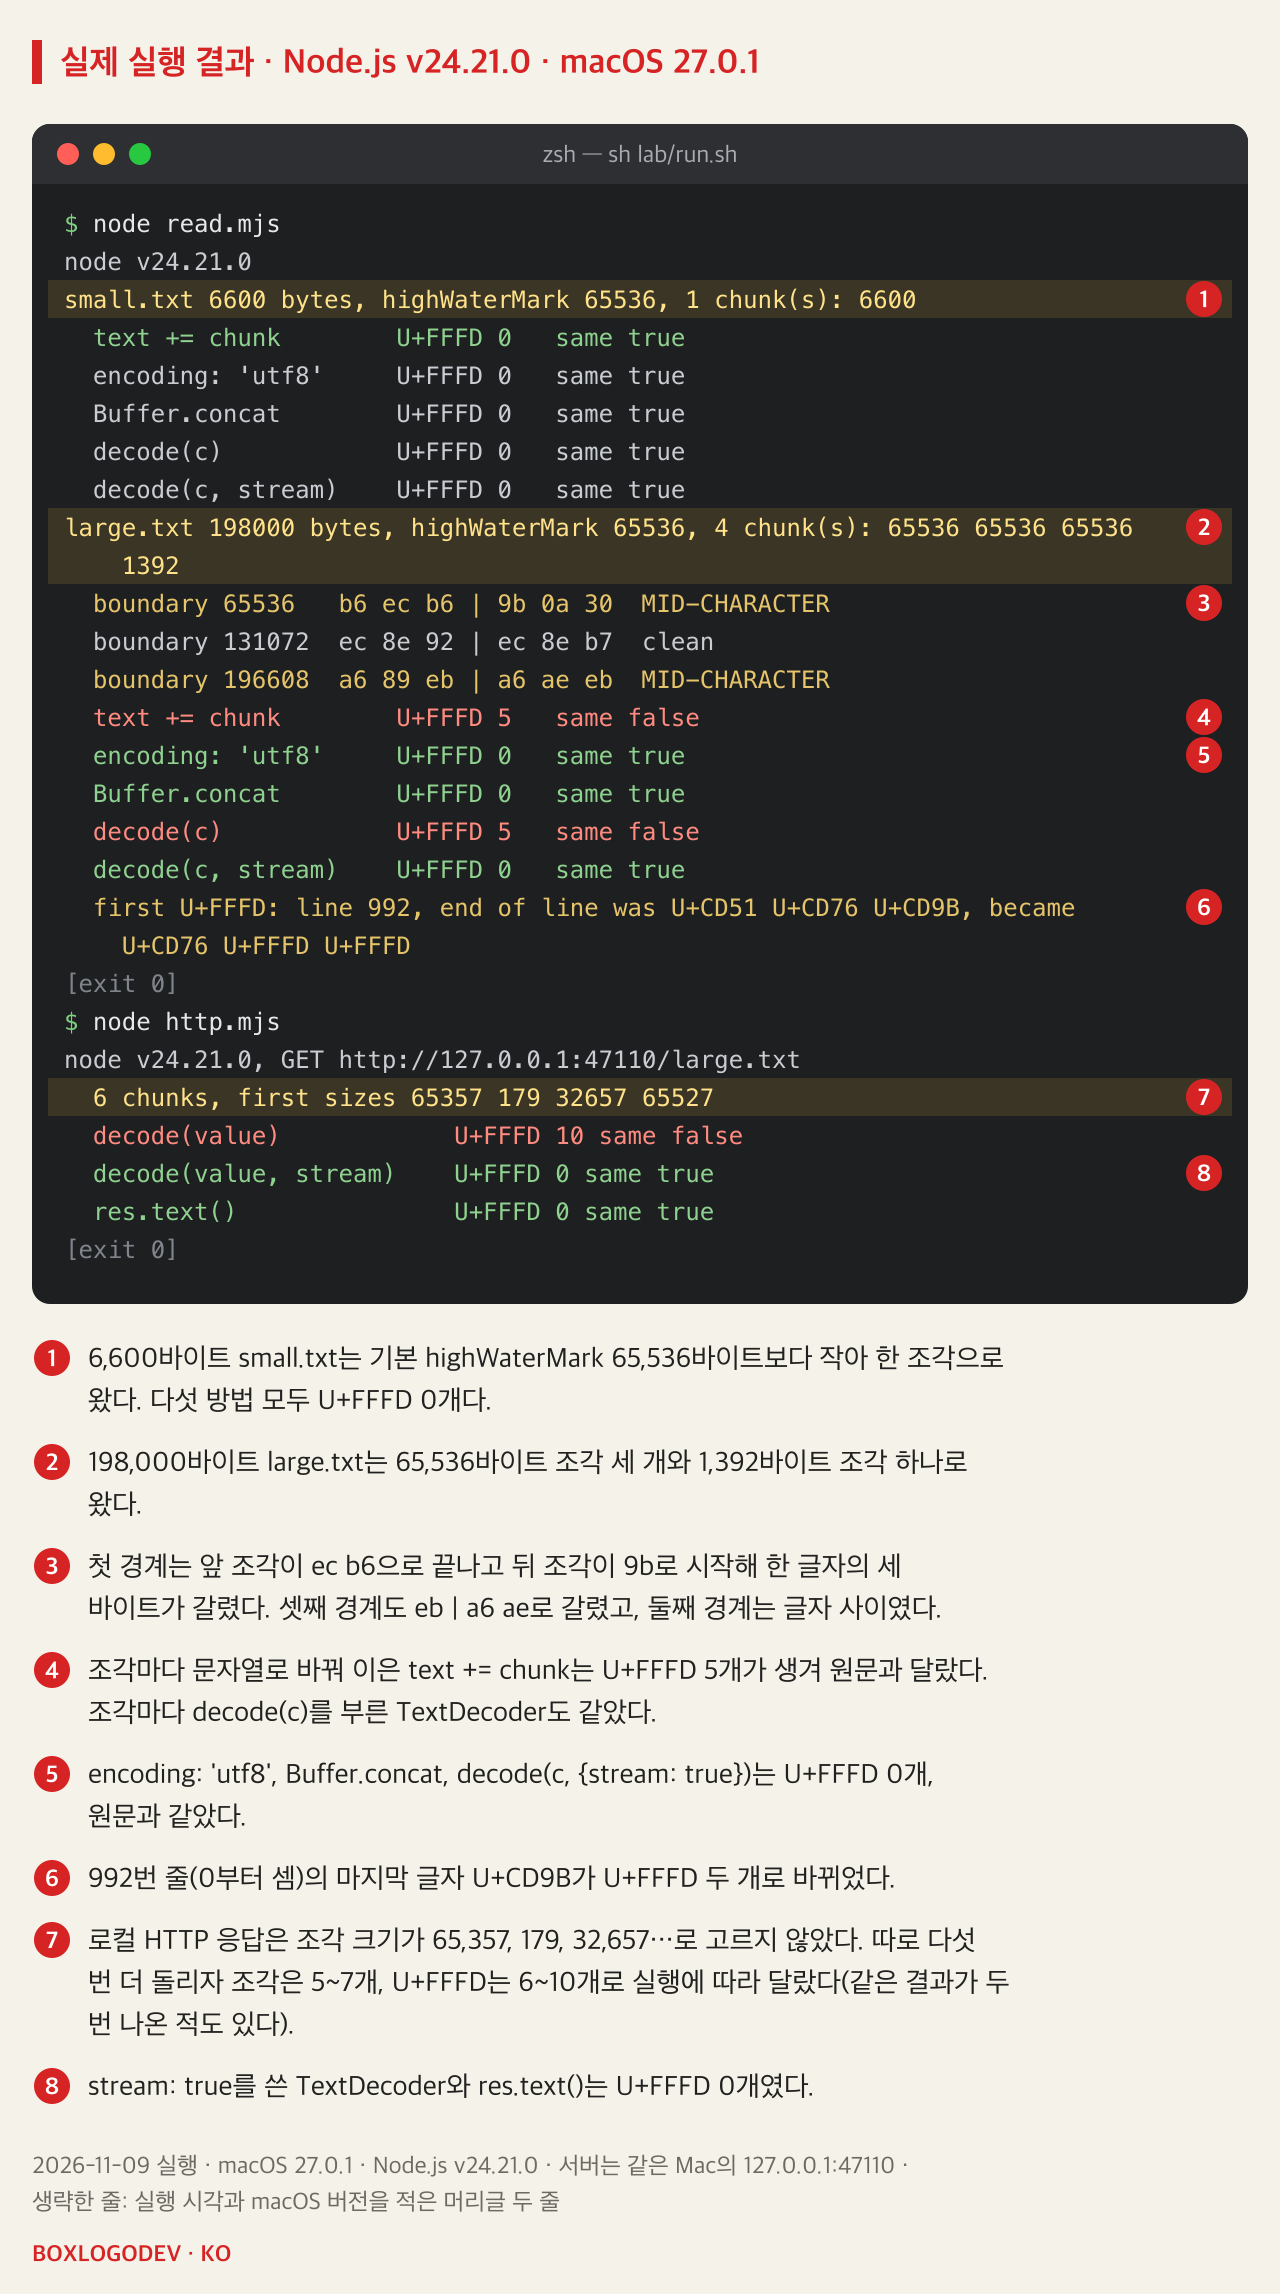
원문 문자열과 비교한 결과가 갈렸습니다. small.txt는 U+FFFD가 0개이고 원문과 같았습니다. large.txt는 U+FFFD가 5개 생겼고 원문과 달랐습니다. 첫 U+FFFD는 0부터 센 992번 줄의 마지막 글자 자리였습니다. U+CD9B(춛)로 끝나야 할 줄이 U+FFFD 두 개로 끝났습니다.
조각은 글자가 아니라 바이트 수로 잘린다
fs.createReadStream은 인코딩을 주지 않으면 데이터를 Buffer 조각으로 넘깁니다. 조각 크기의 기본값(highWaterMark)은 Node.js v24 문서에 64 * 1024, 곧 65,536바이트로 적혀 있고, 실행에서도 readableHighWaterMark가 65536이었습니다. small.txt는 이보다 작아 한 조각으로 왔고, large.txt는 65,536바이트 조각 셋과 1,392바이트 조각 하나로 왔습니다.
문제는 text += chunk입니다. 문자열에 Buffer를 더하면 그 Buffer 하나만 UTF-8로 디코딩해 이어 붙입니다. 조각이 한 글자의 세 바이트 중간에서 잘리면, 앞 조각 끝에 남은 바이트도 뒤 조각의 첫 바이트도 혼자서는 올바른 UTF-8이 아니어서 각각 U+FFFD가 됩니다.
세 경계의 바이트를 찍어 보니 두 곳이 글자 가운데였습니다. 65,536바이트에서는 U+CD9B(ec b6 9b)가 ec b6 | 9b로 갈려 U+FFFD 두 개가 됐습니다. 196,608바이트에서는 U+B9AE(릮, eb a6 ae)가 eb | a6 ae로 갈렸는데, 뒤 조각의 a6과 ae가 하나씩 따로 바뀌어 세 개가 됐습니다. 합해서 다섯 개입니다. 131,072바이트 경계는 우연히 글자와 글자 사이에 떨어져 아무것도 깨지지 않았습니다.
개발 노트
조각 경계가 글자 한가운데에 떨어질 때
198,000바이트 large.txt를 기본 64 KiB 조각으로 읽었을 때의 세 경계
65,536바이트: 한 글자가 2 | 1로 갈림
ec b6 | 9b- U+CD9B(춛)는 UTF-8로 ec b6 9b
- 앞 조각 끝 ec b6 → U+FFFD 1개
- 뒤 조각 앞 9b → U+FFFD 1개
- 992번 줄의 마지막 글자가 U+FFFD 2개로
131,072바이트: 우연히 글자 사이
ec 8e 92 | ec 8e b7- 앞 조각이 한 글자의 끝 바이트 92로 끝남
- 뒤 조각이 U+C3B7(쎷)의 첫 바이트 ec로 시작
- 이 경계에서는 아무것도 깨지지 않았다
196,608바이트: 한 글자가 1 | 2로 갈림
eb | a6 ae- U+B9AE(릮)는 UTF-8로 eb a6 ae
- 앞 조각 끝 eb → U+FFFD 1개
- 뒤 조각 앞 a6, ae → U+FFFD 2개
- 두 경계를 합쳐 U+FFFD 5개
2026-11-09 Node.js v24.21.0에서 lab/read.mjs가 찍은 경계 바이트와, 갈린 바이트를 Buffer로 따로 디코딩해 센 U+FFFD 수다. 한 줄은 66바이트(숫자 네 자리, 공백, 한글 20자, 줄바꿈)다.
그래서 이 버그는 가끔만 보입니다. 파일이 65,536바이트보다 작으면 경계가 없고, 경계가 생겨도 글자 사이에 떨어지면 멀쩡합니다. 이 예제의 줄 번호처럼 영문자, 숫자, 공백, 줄바꿈은 1바이트라 어디서 잘려도 깨질 바이트가 없습니다. 한글처럼 여러 바이트인 글자가 든 큰 파일(기본 조각 64 KiB 기준)에서, 그것도 몇 군데에서만 터집니다.
HTTP 응답은 실행마다 조각과 깨진 개수가 달라질 수 있었다
같은 일이 fetch에서도 일어납니다. 같은 Mac의 127.0.0.1:47110에 이 실험만을 위한 작은 서버를 띄워 large.txt를 보내고, res.body.getReader()로 받은 조각마다 decoder.decode(value)를 불러 이었습니다. 서버는 실행이 끝나면 닫았습니다.
네트워크 조각은 파일처럼 65,536바이트로 고르지 않았습니다. 첫 실행은 65,357, 179, 32,657, 65,527바이트로 이어진 6조각에 U+FFFD 10개였습니다. 따로 다섯 번 더 돌리자 조각은 5~7개, U+FFFD는 6~10개로 실행에 따라 달랐습니다(같은 결과가 두 번 나온 적도 있습니다). 같은 파일인데 깨지는 개수가 실행마다 달라질 수 있으니 로그만 보고 재현하기가 더 어렵습니다. 원격 서버나 프록시를 거치는 경우는 돌려 보지 않았습니다.
앞 조각의 끝을 기억하는 곳에서 디코딩한다
고치는 방법은 모두 같은 원리입니다. 글자 중간에서 끝난 바이트를 버리지 않고 다음 조각이 올 때까지 들고 있다가 함께 디코딩합니다. 아래 세 방법은 돌린 곳(파일 또는 HTTP)에서 모두 U+FFFD 0개, 원문과 같았습니다.
- Node.js 스트림이면 인코딩을 스트림에 맡깁니다.
fs.createReadStream(file, {encoding: 'utf8'})처럼 옵션으로 주거나readable.setEncoding('utf8')을 부릅니다. Node.js 문서는 이렇게 하면 Buffer로 그냥 꺼냈을 때 잘못 디코딩될 여러 바이트 문자를 스트림이 제대로 처리한다고 설명합니다. 이때 조각은 Buffer가 아니라 문자열로 옵니다. - fetch나 웹 스트림이면 TextDecoder에
{stream: true}를 줍니다. 디코더는 하나만 만들어 두고, 조각마다decoder.decode(value, {stream: true})를 부른 뒤 끝에서 인자 없이decoder.decode()를 한 번 더 부릅니다. WHATWG Encoding 표준에서stream의 기본값은 false입니다. stream이 false인 호출은 남은 바이트를 그 자리에서 마무리하고, 그다음 호출은 새 디코더로 시작합니다. true일 때만 덜 끝난 바이트가 다음 호출로 넘어갑니다. - 전체가 한 번에 필요하면 통째로 디코딩합니다. Buffer 조각을 배열에 모았다가
Buffer.concat(chunks).toString('utf8')로 한 번에 바꾸거나, fetch라면await res.text()를 씁니다. 내용 전체를 메모리에 올리므로 아주 큰 파일에는 앞의 두 방법이 맞습니다.
const reader = res.body.getReader();
const decoder = new TextDecoder(); // one decoder for the whole body
let text = '';
for (;;) {
  const {done, value} = await reader.read();
  if (done) break;
  text += decoder.decode(value, {stream: true});
}
text += decoder.decode(); // flush what is left
개발 노트
바이트를 문자열로 바꾸는 곳이 앞 조각의 끝을 기억하게
파일은 다섯 가지, HTTP 응답은 세 가지 방법으로 읽은 결과
피할 코드: 조각마다 따로 디코딩
text += chunk- text += chunk (Buffer마다 따로 문자열로)
- 조각마다 decoder.decode(value)
- large.txt에서 U+FFFD 5개, HTTP에서 6~10개
- 6,600바이트 small.txt는 한 조각이라 0개
Node.js 스트림: 인코딩을 스트림에 맡긴다
{encoding: 'utf8'}- fs.createReadStream(file, {encoding: 'utf8'})
- 또는 readable.setEncoding('utf8')
- 덜 온 바이트를 다음 조각까지 들고 있다
- 결과 U+FFFD 0개, 원문과 같음
fetch와 웹 스트림: stream: true, 끝에 decode()
{stream: true}- decoder.decode(value, {stream: true})
- 끝에서 decoder.decode()를 한 번 더
- 통째로 필요하면 res.text() 또는 Buffer.concat
- 세 방법 모두 U+FFFD 0개
2026-11-09 Node.js v24.21.0에서 lab/read.mjs와 lab/http.mjs(로컬 서버 127.0.0.1:47110)로 돌린 결과다. HTTP 수치는 따로 다섯 번 더 돌린 범위다.
마지막 decoder.decode()는 끝에 덜 끝난 바이트가 남았을 때 그것을 내보냅니다. 41 ec b6 세 바이트를 {stream: true}로 넣으면 A만 나오고, 이어서 부른 decode()가 U+FFFD 하나를 돌려주었습니다. 이것을 빼먹으면 데이터가 글자 중간에서 끊겼다는 흔적이 남지 않습니다. 반대로 올바르게 읽었는데도 끝에 U+FFFD가 있다면, 그것은 디코딩이 아니라 데이터가 잘린 문제입니다.
내 코드에서 찾을 곳과 테스트
찾을 곳은 세 가지입니다. data += chunk처럼 Buffer를 문자열에 바로 더하는 곳, 조각마다 chunk.toString()을 부르는 곳, 조각마다 new TextDecoder()를 만들거나 {stream: true} 없이 decode(value)를 부르는 곳입니다.
테스트에서는 큰 파일을 만들 필요가 없습니다. 한글 30자가 든 99바이트 파일을 highWaterMark: 1로 읽자 text += chunk는 U+FFFD 90개, 곧 한글 90바이트가 하나씩 모두 U+FFFD가 됐고 encoding: 'utf8'은 0개였습니다. 2와 4로 줘도 각각 75개, 40개가 나왔습니다. highWaterMark: 1로 읽고 결과에 '�'가 있는지 세는 테스트 하나면, 경계가 우연히 글자 사이에 떨어져 통과하는 일도 없습니다.
바이트 조각을 문자열로 바꾸는 일은 조각마다 하지 말고, 앞 조각의 끝을 기억하는 디코더 한 곳에 맡기세요.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…