검색창에 C++를 넣으면 프런트엔드가 '/search?q=' + keyword로 주소를 만들어 요청을 보냅니다. 그런데 서버에서 검색어를 꺼내 보면 C 뒤에 공백 두 칸만 남아 있습니다. 이 글을 읽고 나면 쿼리 문자열을 만드는 함수와 읽는 함수 가운데 서로 맞는 짝을 고를 수 있고, +와 공백이 오가는 동안 바뀌지 않게 할 수 있습니다.
예제는 2026-10-25에 macOS 27.0.1에서 실행했습니다. JavaScript는 Node.js v24.21.0의 내장 fetch와, node:http로 만든 로컬 서버(http://127.0.0.1:4392)를 썼습니다. Python은 macOS의 /usr/bin/python3인 Python 3.9.6의 urllib.parse를 썼습니다. 검색 서비스와 검색어는 설명을 위한 가상의 예입니다. 브라우저의 폼 제출은 실행하지 않았습니다.
그대로 재현해 보기
로컬 서버는 요청이 들어오면 받은 주소를 로그에 남기고, q 값을 두 가지 방법으로 읽어 돌려줍니다. 하나는 new URL(req.url, base).searchParams.get('q')이고, 다른 하나는 q= 뒤의 원문을 그대로 decodeURIComponent에 넣는 방법입니다. 클라이언트는 같은 검색어를 세 가지 방법으로 쿼리에 넣어 보냈습니다.
'?q=' + 'C++'                            // 손으로 이어 붙이기
'?q=' + encodeURIComponent('C++')
'?' + new URLSearchParams({ q: 'C++' })
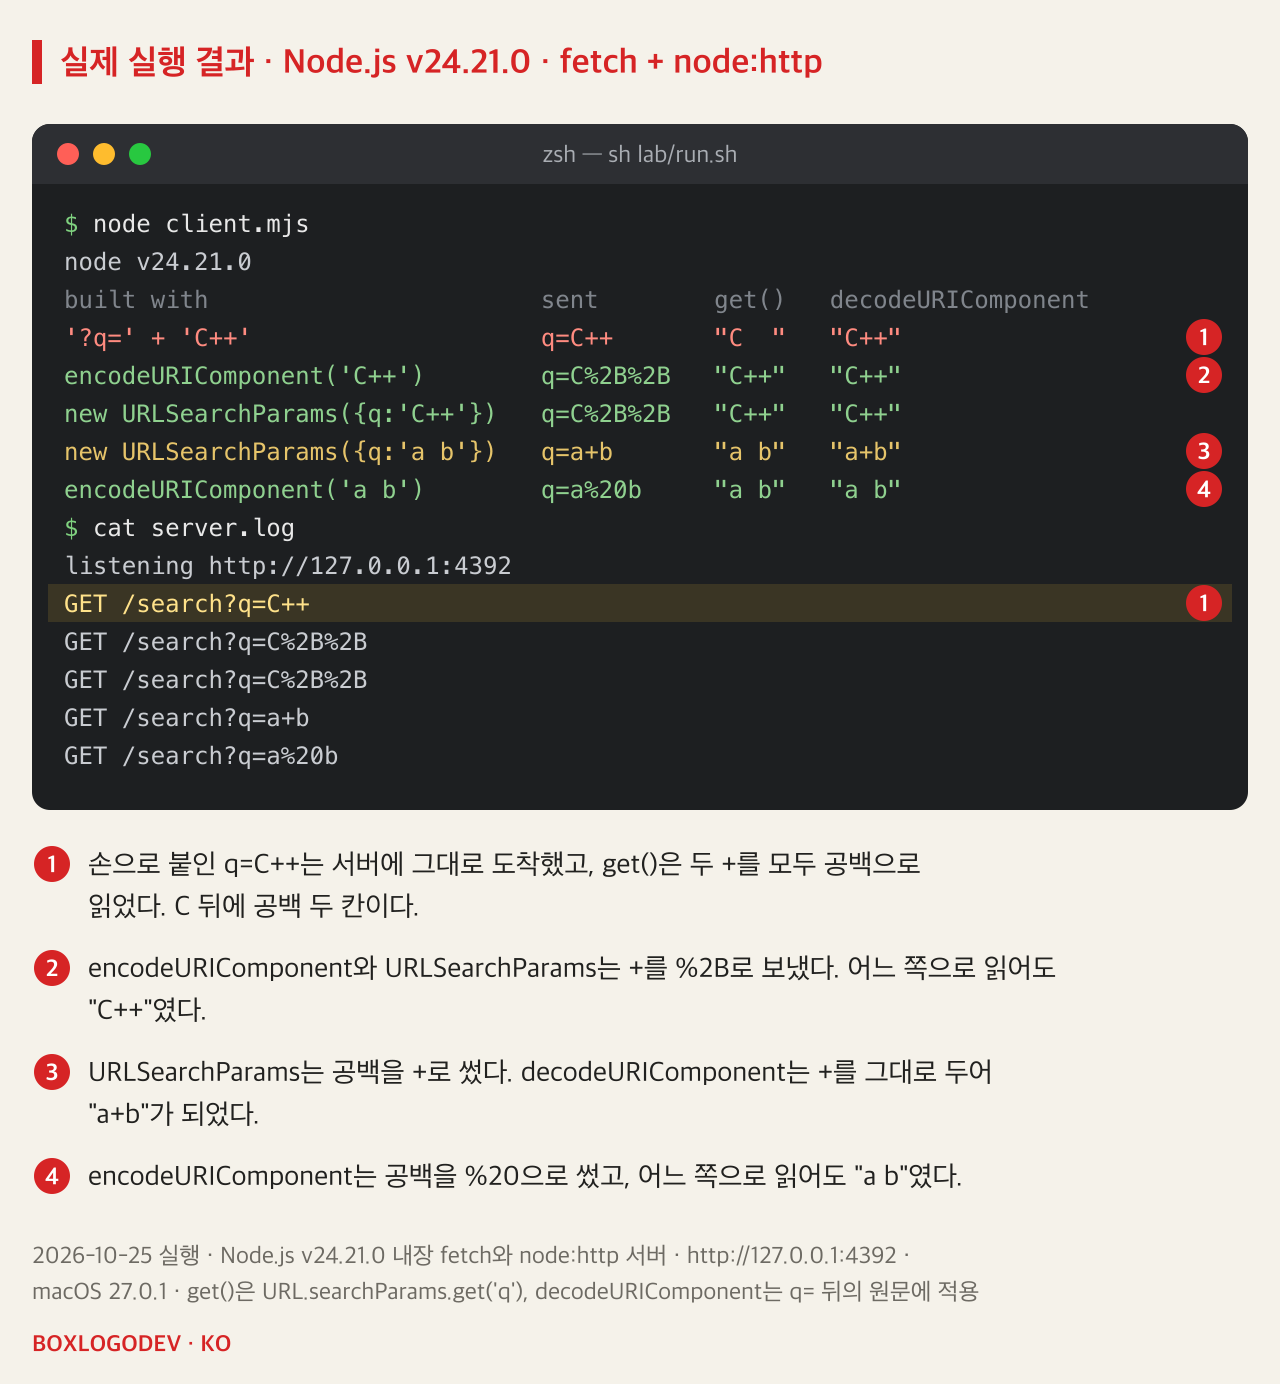
손으로 붙인 주소는 q=C++ 그대로 나갔고, 서버 로그에도 GET /search?q=C++로 찍혔습니다. 오는 도중에 바뀐 글자는 없습니다. 그런데 searchParams.get('q')는 이 값을 C와 공백 두 칸으로 읽었습니다. 같은 원문을 decodeURIComponent로 읽으면 "C++"였습니다. 반대로 encodeURIComponent와 URLSearchParams로 만든 주소는 둘 다 q=C%2B%2B를 보냈고, 두 방법 모두 "C++"로 읽었습니다. 글자가 사라진 곳은 네트워크가 아니라 서버가 값을 읽는 단계였습니다.
+를 공백으로 읽는 형식이 따로 있다
원인은 쿼리 문자열을 읽는 규칙이 하나가 아니라는 데 있습니다. URI의 일반 문법을 정한 RFC 3986에서 +는 !, $, &, = 등과 함께 sub-delims라는 예약 문자 묶음에 들어 있을 뿐, 공백이라는 뜻은 없습니다. 이 문서에서 공백 문자에 해당하는 퍼센트 인코딩은 %20입니다.
공백을 +로 쓰는 것은 application/x-www-form-urlencoded라는 다른 형식입니다. WHATWG URL Standard는 이 형식의 파서에 name과 value 안의 0x2B(+)를 0x20(공백)으로 바꾸는 단계를 두고 있습니다. 같은 문서는 이 형식이 여러 해 동안 쌓인 구현상의 사고와 타협의 결과라고 평하면서도, HTML 폼이 널리 쓰인 탓에 지금도 많이 쓰인다고 적었습니다.
URLSearchParams는 읽을 때도 쓸 때도 이 형식을 따릅니다. 명세에서 생성자는 문자열을 이 형식의 파서로 읽고, 문자열로 바꿀 때는 이 형식의 직렬화 규칙을 씁니다. MDN도 URLSearchParams 생성자가 더하기 기호(+)를 공백으로 해석한다고 경고하고, 직렬화할 때는 공백을 +로 쓴다고 설명합니다. URL 객체의 searchParams 속성도 URLSearchParams 객체를 돌려주므로, 서버의 searchParams.get이 +를 공백으로 바꾼 것입니다.
encodeURIComponent와 decodeURIComponent는 이 형식을 모릅니다. MDN에 따르면 encodeURIComponent는 영문자, 숫자와 - _ . ! ~ * ' ( )를 뺀 모든 문자를 이스케이프하므로 +는 %2B, 공백은 %20이 됩니다. decodeURIComponent는 %로 시작하는 이스케이프만 풀고 +는 그대로 둡니다. MDN이 쿼리 매개변수를 읽는 예제에서 decodeURIComponent를 부르기 전에 +를 공백으로 먼저 바꾸는 것도 이 때문입니다.
어긋남은 두 방향으로 일어난다
첫 번째 방향은 앞에서 본 경우입니다. 클라이언트가 값을 인코딩하지 않고 붙이면 +가 원문 그대로 나가고, 폼 형식으로 읽는 서버는 그것을 공백으로 바꿉니다. C++뿐 아니라 +가 의미를 갖는 값이면 모두 같은 일을 겪습니다. MDN의 URLSearchParams 문서는 Base64 문자열에 든 +가 공백으로 바뀌어 원래 데이터로 되돌릴 수 없게 되는 예를 보여 줍니다.
두 번째 방향은 반대입니다. 클라이언트가 new URLSearchParams({ q: 'a b' })로 주소를 만들면 공백이 +가 되어 q=a+b로 나갑니다. 서버가 이것을 decodeURIComponent로 읽으면 공백이 아니라 "a+b"가 남습니다. 실행 결과에서도 searchParams.get은 "a b", decodeURIComponent는 "a+b"였습니다. 쓰는 쪽은 규칙대로 인코딩했지만, 읽는 쪽이 다른 형식을 기대한 것입니다.
눈여겨볼 줄이 하나 더 있습니다. encodeURIComponent('a b')가 만든 q=a%20b는 두 방법 모두 "a b"로 읽었습니다. %20과 %2B는 폼 형식 파서로 읽어도, decodeURIComponent로 읽어도 같은 글자가 됩니다. 원문에 +를 남기지 않으면 이 어긋남은 생기지 않습니다.
Python에서도 똑같이 갈린다
서버가 Python이어도 사정은 같습니다. urllib.parse에는 두 계열의 함수가 나란히 있습니다. 공식 문서는 quote_plus를 quote()와 같되 공백을 더하기 기호로 바꾸는 함수로, unquote_plus를 unquote()와 같되 더하기 기호를 공백으로 바꾸는 함수로 설명하고, 둘 다 HTML 폼 값에 필요한 동작이라고 적었습니다. urlencode는 기본으로 quote_plus를 쓰며, parse_qs와 parse_qsl은 application/x-www-form-urlencoded 데이터를 읽는 함수입니다.
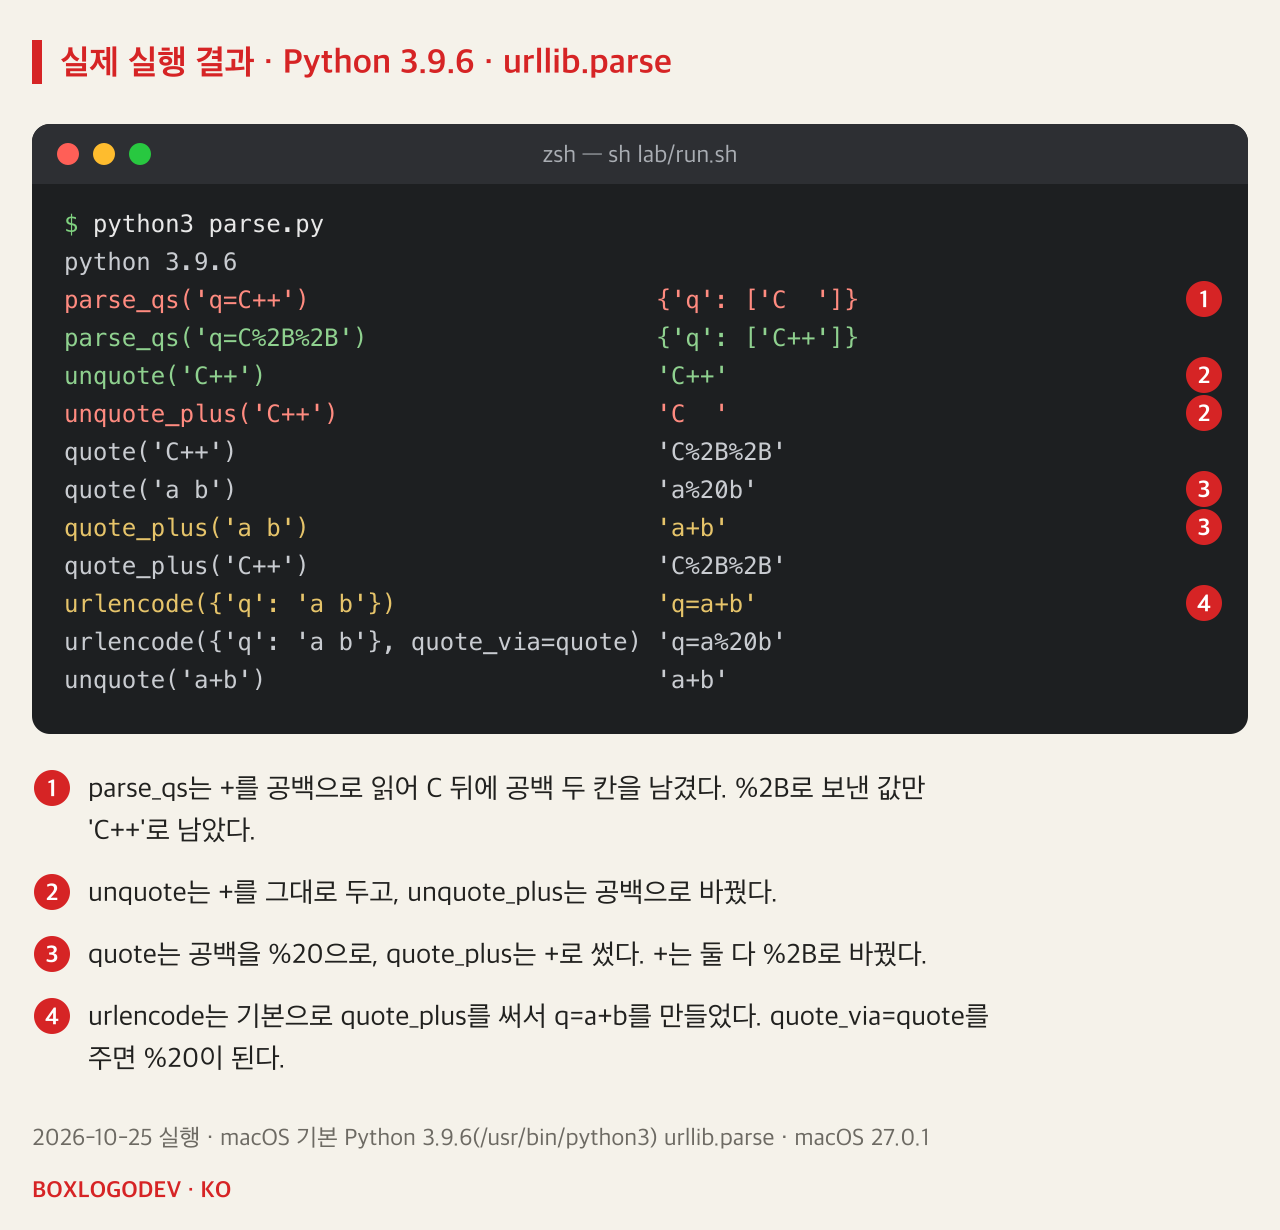
Python 3.9.6에서 실행해 보니 parse_qs('q=C++')는 C 뒤에 공백 두 칸이 붙은 값을 돌려주었습니다. Node.js의 searchParams.get과 같은 결과입니다. %2B로 보낸 parse_qs('q=C%2B%2B')만 'C++'였습니다. unquote('C++')는 'C++'를 그대로 두었고, unquote_plus('C++')는 다시 공백 두 칸을 만들었습니다. 쓰는 쪽에서는 quote('a b')가 'a%20b', quote_plus('a b')가 'a+b'를 만들었고, + 자체는 두 함수 모두 %2B로 바꿨습니다. urlencode({'q': 'a b'})는 'q=a+b'였고, quote_via=quote를 넘기면 'q=a%20b'가 되었습니다.
쓰는 함수와 읽는 함수를 짝으로 고른다
고치는 방법은 단순합니다. 쿼리 문자열에 값을 손으로 이어 붙이지 말고, 값마다 인코딩하는 함수를 거치게 하십시오. JavaScript에서는 다음 두 가지 가운데 하나를 쓰면 됩니다. 앞의 실행에서 클라이언트가 보낸 방식과 같습니다.
const BASE = 'http://127.0.0.1:4392/search';
await fetch(BASE + '?' + new URLSearchParams({ q: keyword }));
await fetch(BASE + '?q=' + encodeURIComponent(keyword));
읽는 쪽은 쓰는 쪽에 맞춥니다. URLSearchParams나 Python urlencode처럼 공백을 +로 쓰는 쪽에서 온 값은 searchParams.get, parse_qs, unquote_plus처럼 +를 공백으로 읽는 함수로 읽어야 합니다. decodeURIComponent나 unquote로 읽으면 공백 자리에 +가 남습니다. 반대로 encodeURIComponent나 quote가 만든 값은 %20과 %2B만 쓰므로, 실행해 본 두 가지 읽기 방법 어느 쪽으로도 같은 값이 나왔습니다.
두 가지를 더 조심하십시오. MDN은 URLSearchParams를 동적으로 이어 붙인 문자열로 만들지 말고 append()를 쓰라고 권합니다. new URLSearchParams('q=' + keyword)는 손으로 붙인 주소와 마찬가지로 +를 공백으로 읽기 때문입니다. 또 MDN에 따르면 URL 객체의 search는 공백을 %20으로, searchParams는 +로 인코딩하므로, searchParams를 한 번 고치면 값이 같아도 주소의 모양이 달라질 수 있습니다.
개발 노트
공백은 무엇으로 쓰고, +는 무엇으로 읽나
폼 형식 함수는 +를 공백으로 읽고, 퍼센트 인코딩 함수는 +를 그대로 둔다
URLSearchParams (JavaScript)
q=a+b → get('q') = 'a b'- 쓰기: 공백 → +, + → %2B
- 읽기: + → 공백
Python 폼 함수
urlencode({'q': 'a b'}) → 'q=a+b'- quote_plus, urlencode
- → 공백을 +로 쓴다
- parse_qs, unquote_plus
- → +를 공백으로 읽는다
encodeURIComponent · decodeURIComponent
decodeURIComponent('a+b') → 'a+b'- 쓰기: 공백 → %20, + → %2B
- 읽기: +는 그대로 +
Python quote · unquote
unquote('C++') → 'C++'- 쓰기: 공백 → %20, + → %2B
- 읽기: +는 그대로 +
Node.js v24.21.0과 Python 3.9.6에서 2026-10-25에 실행해 확인했다. 둘을 가르는 것은 읽는 쪽이 +를 공백으로 바꾸는지다.
검색어에서 +가 사라졌다면 서버 로그에 찍힌 원문부터 보십시오. q=C++처럼 +가 그대로 있으면 보낸 쪽이 인코딩하지 않은 것이고, q=a+b를 decodeURIComponent로 읽어 +가 남았다면 읽는 쪽이 폼 형식을 몰랐던 것입니다. 기억할 것은 한 줄입니다. +는 폼 형식 파서에게만 공백입니다.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…