ABAP 내부 테이블: STANDARD·SORTED·HASHED를 고르는 기준
내부 테이블을 선언할 때 “많으면 HASHED가 빠르다”부터 생각하면 정작 필요한 동작을 놓치기 쉽습니다. 같은 ID가 여러 번 나와도 되는지, 입력된 줄의 위치가 중요한지, ID 순서로 묶어 읽을 것인지에 따라 선택이 달라집니다. 먼저 데이터가 지켜야 할 규칙을 정하고, 그다음 자주 실행할 읽기 방식에 맞추는 편이 이해하기 쉽습니다.
내부 테이블은 ABAP 프로그램이 메모리에서 다루는 데이터입니다. 데이터베이스 테이블의 인덱스를 바꾸는 이야기는 아닙니다. 여기서는 보조 키가 없는 테이블의 기본 키와 기본 인덱스만 비교합니다. 코드는 ABAP 7.51 문법 범위를 전제로 한 가상 예제이며, 실제 SAP 시스템에서 실행하거나 성능을 측정하지 않았습니다.
1. 세 줄을 넣기 전에, 무엇을 남길지 정한다
ID와 표시 문자라는 두 필드가 있다고 가정하겠습니다. 넣으려는 순서는 1002/B, 1001/A, 1002/C입니다. B와 C는 내용이 다른 두 행이지만 ID는 같습니다. ID를 키로 정했다면 이 둘은 ‘중복 키’이고, 행 전체가 똑같다는 뜻은 아닙니다. 이 구분을 먼저 해야 중복 허용 여부를 제대로 고를 수 있습니다.
STANDARD TABLE의 기본 키는 비고유입니다. 이 예제를 차례로 APPEND하면 세 행이 그대로 들어가고 위치는 1002/B → 1001/A → 1002/C가 됩니다. ID가 1001인 행을 나중에 넣었다고 자동으로 첫 줄로 옮기지 않습니다. 순서대로 읽거나 특정 줄 번호로 접근할 때 자연스럽습니다. 다만 SORT나 위치를 지정한 삽입을 하면 줄의 순서는 달라지므로, 입력 순서가 영원히 고정되는 자료형이라고 이해하면 곤란합니다.
SORTED TABLE은 기본 키의 오름차순을 유지합니다. ID를 NON-UNIQUE KEY로 선언하고 세 행을 넣으면 1001이 앞에 오고, 그 뒤에 1002인 두 행이 놓입니다. 도해에서는 같은 ID 두 행을 한 묶음으로 표시했습니다. B와 C 중 무엇이 먼저여야 한다는 업무 규칙까지 ID 하나로 표현한 것은 아닙니다. 같은 ID 안에서도 접수 순번을 지켜야 한다면 그 순번을 데이터와 키 설계에 어떻게 담을지 별도로 정해야 합니다.
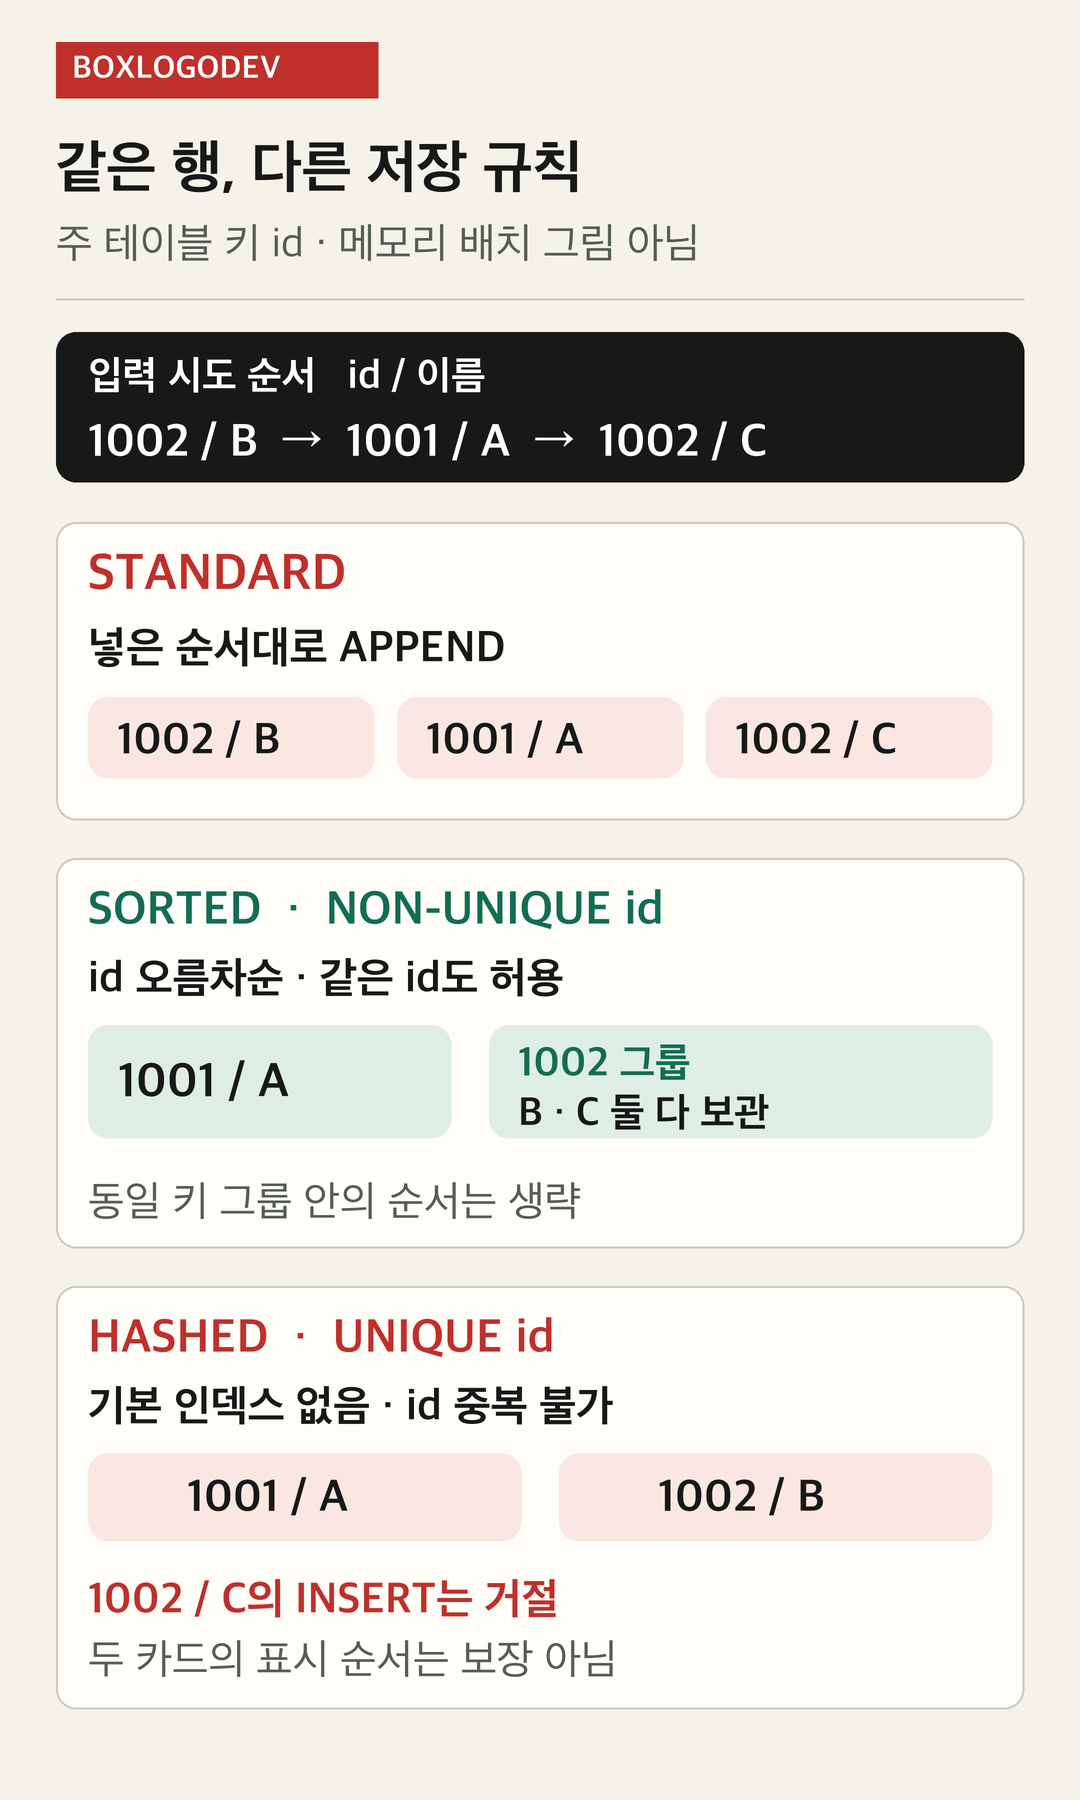
가상 데이터 세 줄을 비교한다. SORTED의 동일 ID 묶음은 B와 C의 선후 관계를 약속하지 않는다.
2. 중복을 남길지 막을지가 테이블의 의미를 바꾼다
SORTED의 기본 키에는 UNIQUE와 NON-UNIQUE를 선택할 수 있지만, HASHED의 기본 키는 UNIQUE여야 합니다. 따라서 ID별로 여러 기록을 남기려는 목록을 HASHED TABLE WITH UNIQUE KEY id로 바꾸면 요구사항이 달라집니다. 선언 한 줄만 바꾸는 최적화로 보기 전에, 같은 ID 두 행이 실제로 없어도 되는지부터 확인해야 합니다.
HASHED 예제에서 1002/B와 1001/A를 먼저 넣은 뒤, 1002/C를 단일 INSERT ... INTO TABLE 문으로 넣으면 어떨까요. ID 1002가 이미 있으므로 마지막 삽입은 이루어지지 않고 sy-subrc는 4가 됩니다. 기존 B가 C로 바뀌는 동작도 아닙니다. 아래는 각 삽입 직후 반환값을 별도 변수에 남기는 최소 예제입니다. 결과를 읽는 방법을 설명하기 위한 코드이며 실행 결과 화면은 아닙니다.
TYPES: BEGIN OF ty_row,
  id TYPE i,
  label TYPE c LENGTH 1,
END OF ty_row.

DATA lt_by_id
  TYPE HASHED TABLE OF ty_row
  WITH UNIQUE KEY id.

INSERT VALUE #(
  id = 1002 label = 'B' )
  INTO TABLE lt_by_id.
DATA(rc1) = sy-subrc.

INSERT VALUE #(
  id = 1001 label = 'A' )
  INTO TABLE lt_by_id.
DATA(rc2) = sy-subrc.

INSERT VALUE #(
  id = 1002 label = 'C' )
  INTO TABLE lt_by_id.
DATA(rc3) = sy-subrc.
문서상 기대값은 rc1과 rc2가 0, rc3가 4입니다. 최종 행은 1002/B와 1001/A 두 개이며, 표시 순서까지 뜻하지는 않습니다. 중복을 만났을 때 별도 목록에 남길지, 오류로 처리할지, 명시적으로 갱신할지는 프로그램이 결정해야 합니다. 이 설명은 보조 키 없이 기본 고유 키로 한 행씩 넣는 위 구문에 한정됩니다. 여러 행을 한꺼번에 넣거나 다른 방식으로 대입할 때의 중복 처리를 같은 반환값 규칙으로 일반화하지 마세요.
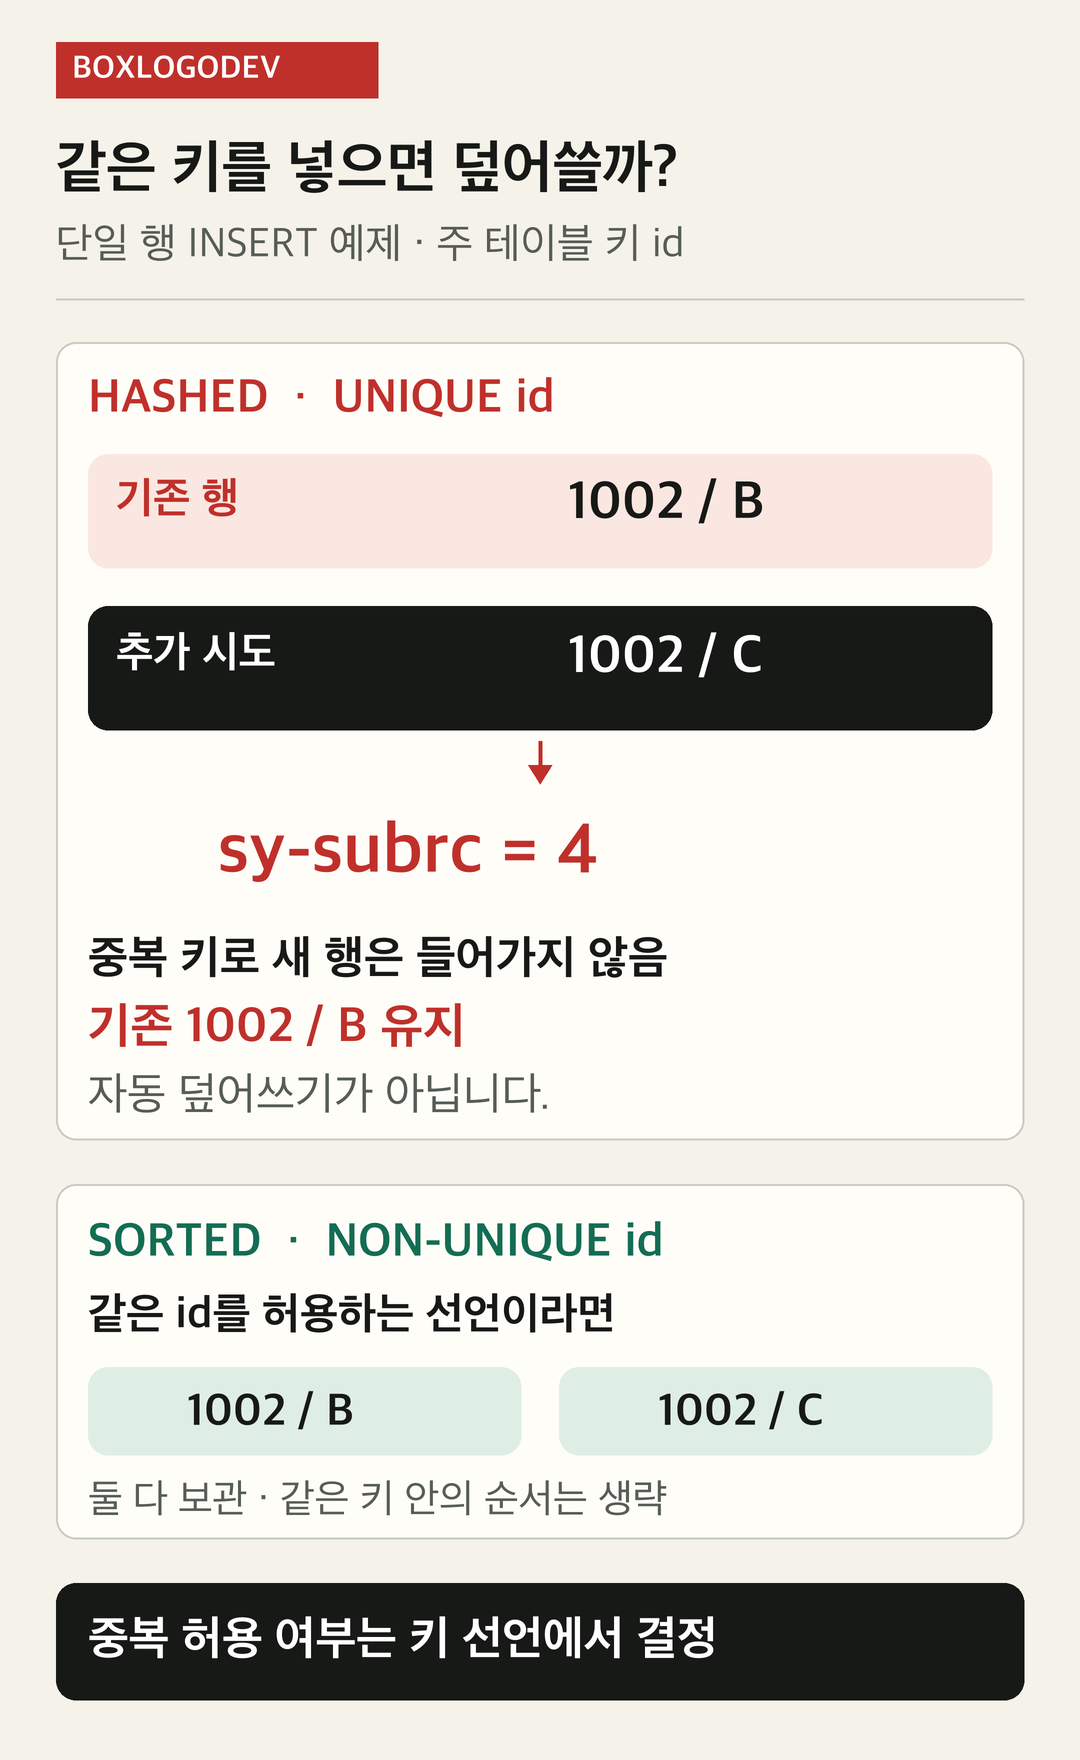
NON-UNIQUE는 두 기록을 보존한다. UNIQUE 기본 키의 단일 INSERT 실패는 기존 행을 덮어쓰지 않는다.
3. ‘어떤 값으로 찾나’와 ‘몇 번째 줄인가’를 나눈다
STANDARD와 SORTED에는 기본 인덱스가 있어 줄 번호로 접근할 수 있습니다. 반면 HASHED에는 기본 인덱스가 없습니다. “지금 두 번째 줄을 읽고 다음 줄로 이동한다”는 처리와 “ID 1002에 해당하는 한 행을 찾는다”는 처리는 서로 다른 요구입니다. 화면에 두 번째로 보이는 항목이 필요하다면 먼저 표시 순서와 그 순서를 표현할 구조를 정하는 것이 좋습니다.
기본 키로 한 행을 찾는 경우 STANDARD는 선형 탐색, SORTED는 이진 탐색, HASHED는 해시 접근을 사용합니다. 그러나 테이블 이름만 바꾸면 아무 조건이나 같은 방식으로 빨라지는 것은 아닙니다. SORTED의 부분 키 탐색은 키의 앞부분을 조건으로 삼는지, HASHED의 해시 접근은 완전한 키 값이 주어지는지가 중요합니다. 여기서는 키가 ID 하나뿐이므로 ID를 지정하면 완전한 키가 됩니다.
예를 들어 ID와 접수 순번을 함께 키로 쓴다면, ID만 아는 상황은 복합 키 전체를 아는 상황과 다릅니다. 또한 ID가 여러 번 나오는 SORTED에서 한 행을 읽는 것과 같은 ID의 모든 기록을 순회하는 것은 결과의 범위가 다릅니다. 필요한 결과가 한 건인지 여러 건인지까지 적어 두면 조회 구문을 고를 때 혼동이 줄어듭니다.
데이터가 많다는 이유만으로 HASHED를 정답으로 정할 필요는 없습니다. 삽입·변경 빈도, 메모리와 관리 비용, 실제 조회 조건을 함께 봐야 합니다. 이 글의 세 행은 규칙을 이해하기 위한 데이터이므로 속도 차이를 보여 주는 벤치마크로 쓰지 않습니다. 보조 키를 추가하면 선택지가 넓어지지만 그 유지 비용과 사용 구문까지 다뤄야 하므로 여기서는 제외했습니다.
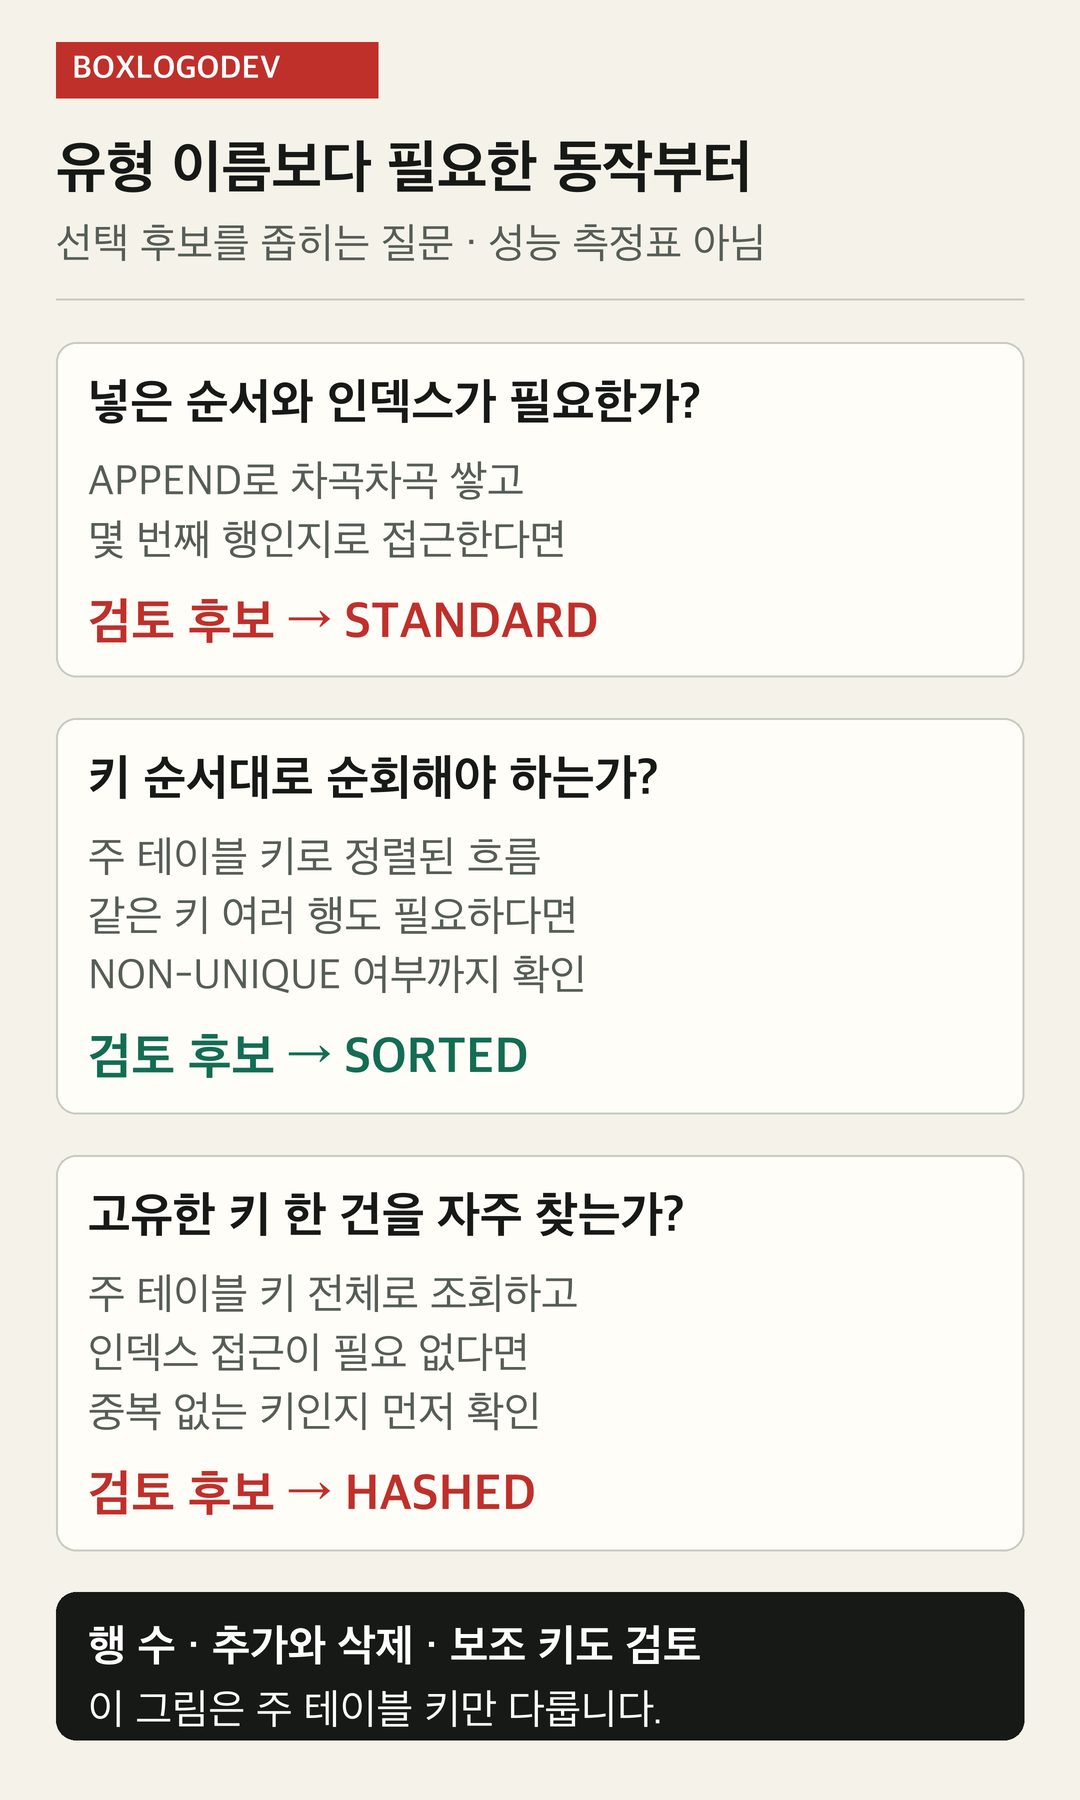
중복 허용, 정렬 유지, 줄 번호 접근, 완전한 키 조회를 차례로 확인해 후보를 좁힌다.
4. 선언을 바꾸기 전에 작은 표로 확인한다
선택 과정을 한 문장으로 적어 보세요. “세 기록을 입력 순서대로 담아 전체를 읽는다”면 STANDARD를, “같은 ID의 여러 기록을 남기고 ID 순서를 계속 유지한다”면 NON-UNIQUE인 SORTED를 검토할 수 있습니다. “ID마다 한 행만 있고 완전한 ID로 반복해서 찾는다”면 HASHED를 후보로 삼을 수 있습니다. 이들은 출발점이며, 정렬과 줄 번호 접근도 필요하다면 UNIQUE인 SORTED가 맞을 수도 있습니다.
직접 확인할 때는 먼저 세 행을 넣고 행 개수를 세어 보세요. 다음으로 ID 1002가 몇 행인지, 그중 어떤 표시 문자가 남았는지, 줄 번호 접근이 요구사항에 있는지를 확인합니다. 그다음 없는 ID를 찾는 경우와 중복 ID를 다시 넣는 경우를 추가합니다. 테이블 종류를 바꿔도 이 기대 결과가 그대로여야 하는지 합의한 뒤 실제 환경에서 구문과 동작을 검증하면, 성능 개선 과정에서 데이터의 의미를 바꾸는 실수를 줄일 수 있습니다.