글자 수 제한을 length로 걸어 두었더니 가족 이모지(👨👩👧👦) 하나가 11로 세어지거나, 말줄임을 slice()로 넣은 뒤 서버에서 인코딩 오류가 난다면 같은 곳을 봐야 합니다. length가 세는 것은 글자가 아닙니다. 이 글을 읽고 나면 한 문자열을 세는 네 가지 단위를 구분하고, 화면 제한과 저장 제한, 자르기에 어느 단위를 쓸지 정할 수 있습니다.
예제는 2026-11-01에 macOS 27.0.1에서 Node.js v24.21.0(ICU 78.3, Unicode 17.0)과 Python 3.9.6, 3.12.14로 실행했습니다. 동작은 MDN, HTML·Infra·Encoding 표준, Unicode UAX #29로 확인했고, 브라우저에서는 실행하지 않았습니다. 입력은 모두 가상의 값입니다.
같은 입력을 네 단위로 세어 보기
입력 아홉 개를 samples.json에 적어 두고 Node.js와 Python이 같은 파일을 읽게 했습니다. Node.js에서 세는 함수는 아래 세 개이고, 나머지 한 단위는 s.length입니다.
const segmenter = new Intl.Segmenter("en", { granularity: "grapheme" });
const encoder = new TextEncoder();

const graphemes = (s) => [...segmenter.segment(s)].length;
const codePoints = (s) => [...s].length;
const utf8Bytes = (s) => encoder.encode(s).length;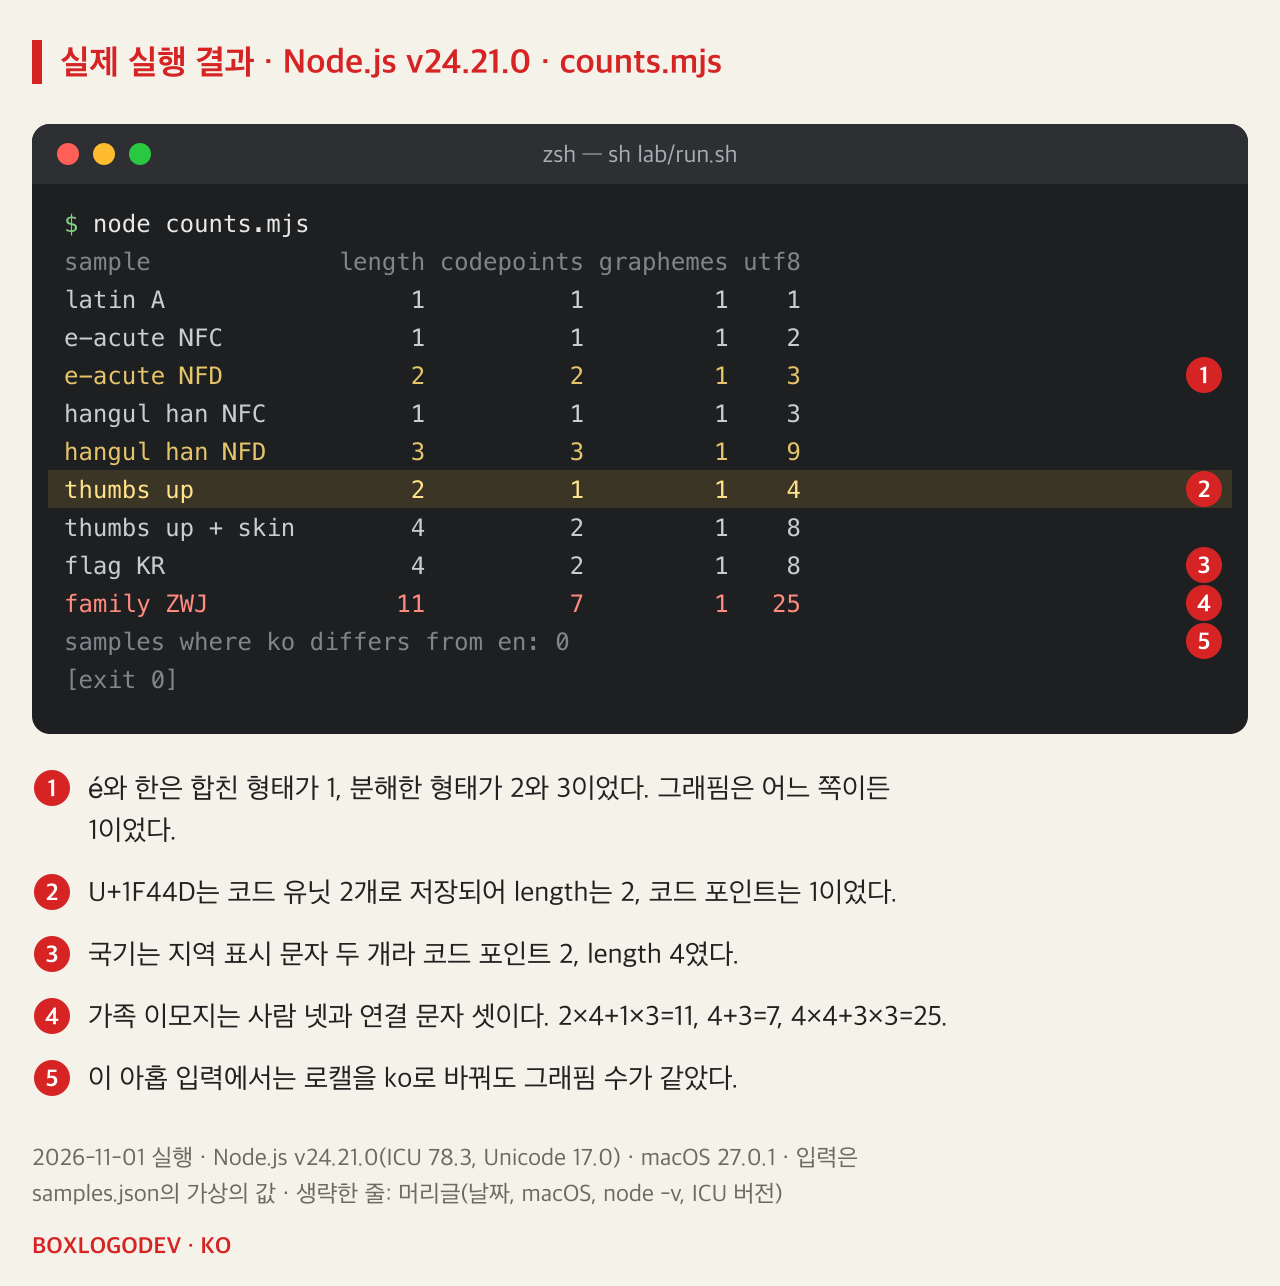
가족 이모지는 사람 넷(U+1F468, U+1F469, U+1F467, U+1F466)을 연결 문자 U+200D 셋으로 이은 것입니다. 사람 하나는 UTF-16 코드 유닛 2개, 연결 문자는 1개이므로 length는 2×4+1×3=11입니다. 코드 포인트는 4+3=7입니다. UTF-8로는 사람 하나가 4바이트, 연결 문자가 3바이트라서 4×4+3×3=25입니다.
MDN도 length를 UTF-16 코드 유닛의 수로 설명하면서, 실제 문자 수와 다를 수 있다고 적습니다. 코드 포인트로 세어도 사람이 한 글자로 읽는 단위와는 다릅니다. 그 단위에 가까운 것이 그래핌 클러스터이고, UAX #29가 경계 규칙을 정합니다. Intl.Segmenter로 세자 아홉 입력 모두 1이었습니다.
이 1에는 조건이 둘 붙습니다. UAX #29는 자신의 규칙을 기본값이라고 하면서 구현이 조정할 수 있다고 적고, MDN은 Intl.Segmenter를 로캘에 민감한 기능으로 설명합니다. ko와 en의 결과가 같았다는 것은 이 ICU 버전과 이 아홉 입력에서 본 결과일 뿐입니다. 또 그래핌 1이 곧 그림 하나는 아닙니다. UTS #51에 따르면 이 조합을 한 그림으로 지원하지 않는 환경에서는 연결 문자가 무시되고 이모지가 따로따로 보일 수 있습니다.
slice()로 자르면 문자열이 깨질 수 있다
앞 세 글자만 남기는 코드를 세 가지로 썼습니다. 입력 name은 "ok", 가족 이모지, "!"를 이은 문자열이고 length는 14입니다.
const byUnit = name.slice(0, 3);
const byCodePoint = [...name].slice(0, 3).join("");
const byGrapheme = [...segmenter.segment(name)].slice(0, 3).map((x) => x.segment).join("");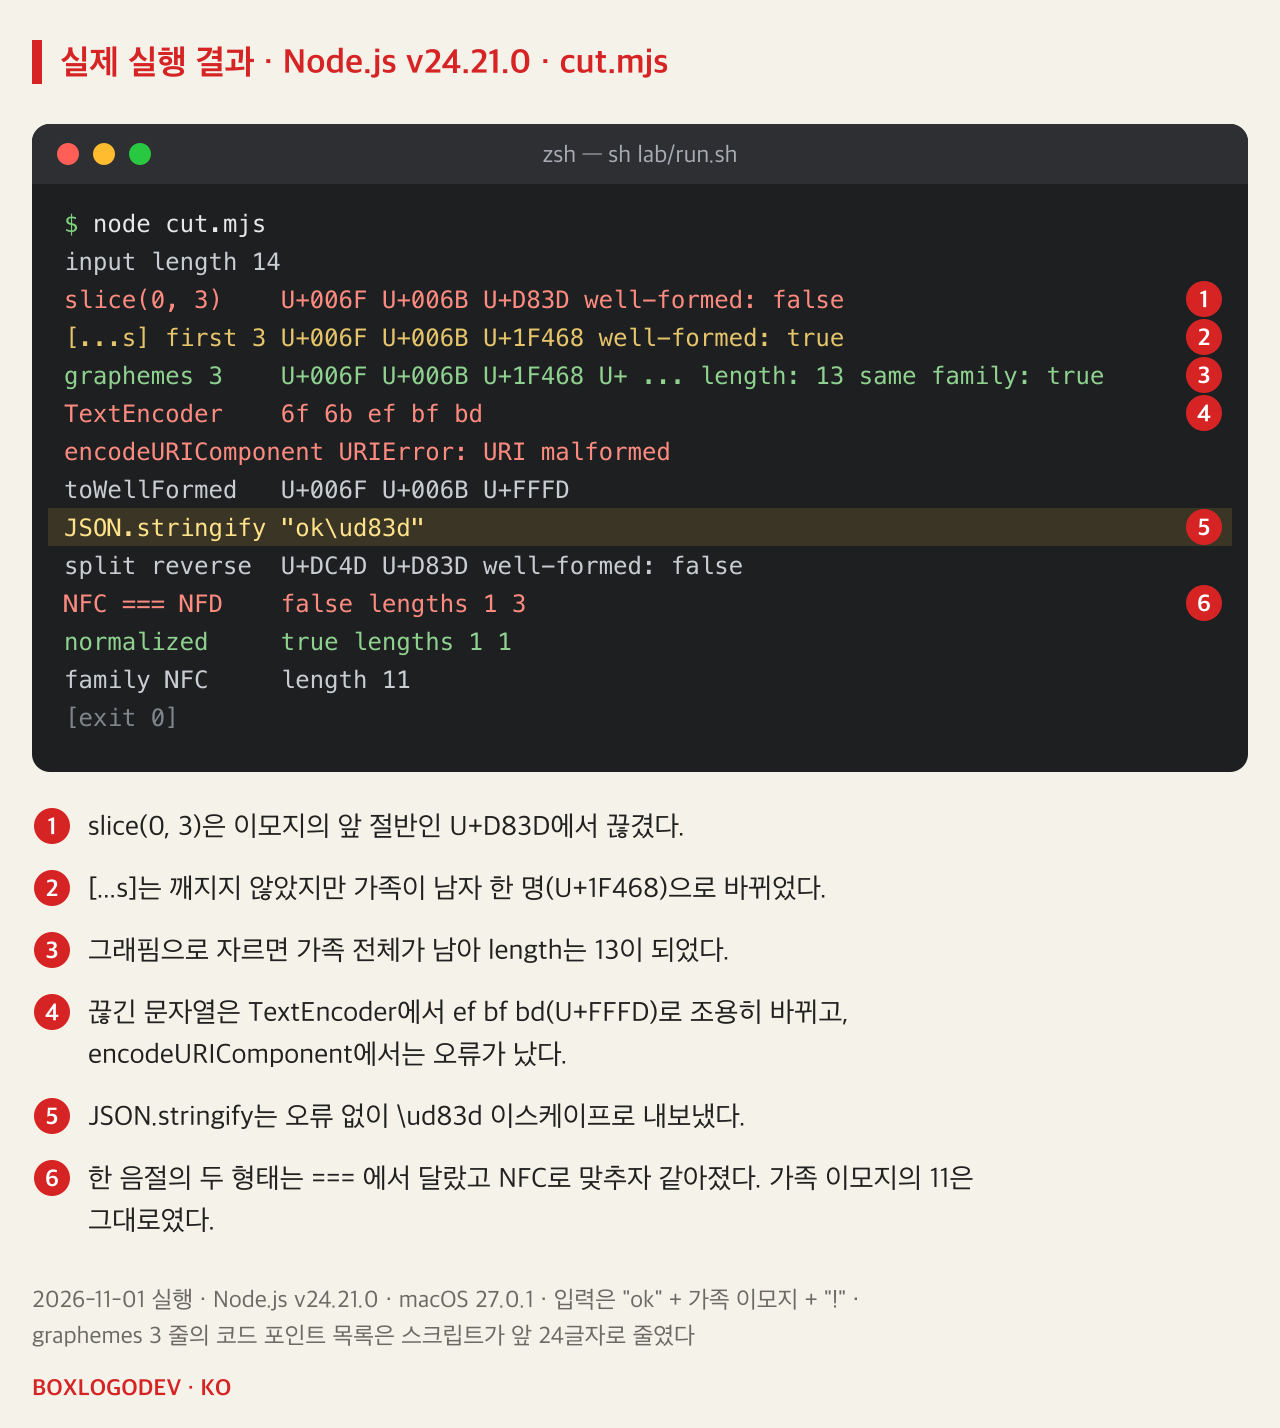
slice(0, 3)은 U+D83D에서 끊겼습니다. 이모지 U+1F468을 이루는 서로게이트 쌍의 앞쪽만 남은 것이고, MDN의 설명대로 이렇게 혼자 남은 코드 유닛은 어떤 문자도 나타내지 못합니다. isWellFormed()도 false였습니다. 배열로 자른 결과는 깨지지 않았지만, 가족이 남자 한 명(U+1F468)으로 바뀌었고 오류는 나지 않았습니다. 그래핌으로 자른 결과에만 가족이 그대로 남았고, 그래서 length는 3이 아니라 13입니다.
끊긴 문자열은 밖으로 나가는 경로마다 다르게 드러났습니다. TextEncoder는 끊긴 자리를 U+FFFD의 UTF-8인 ef bf bd로 바꾸어 오류 없이 내보냈습니다. Encoding 표준이 입력을 USVString으로 받고, Infra 표준이 그 변환에서 서로게이트를 U+FFFD로 바꾼다고 정한 것과 맞습니다. encodeURIComponent()는 URIError를 냈습니다. JSON.stringify()는 \ud83d 이스케이프로 오류 없이 내보냈는데, 이 JSON을 Python이 읽으면 json.loads()는 통과하고 UTF-8로 인코딩할 때 UnicodeEncodeError가 납니다. 자른 프로그램과 오류가 난 프로그램이 다른 것입니다.
toWellFormed()는 끊긴 자리를 U+FFFD로 바꿔 줄 뿐 잃은 글자를 되살리지는 않습니다. split("")도 코드 유닛으로 나누므로, split("").reverse().join("")로 뒤집은 U+1F44D는 U+DC4D U+D83D가 되어 깨졌습니다.
눈에 같은 글자도 길이가 다를 수 있다
이모지가 없어도 숫자는 갈립니다. 음절 한(U+D55C)은 자모 셋(U+1112, U+1161, U+11AB)으로 분해해 적을 수 있습니다. 첫 그림에서 length는 1과 3, UTF-8은 3바이트와 9바이트였고, 그래핌은 둘 다 1이었습니다. 그런데 ===는 false를 냅니다. MDN이 적은 대로 코드 포인트가 다르면 문자열 비교는 같다고 보지 않습니다. normalize("NFC")로 맞추자 true가 되고 길이도 1이 되었습니다.
정규화가 글자 수 문제를 대신 풀어 주지는 않습니다. 가족 이모지는 NFC로 바꿔도 length가 11이었고, Python에서 국기는 2, 가족은 7 그대로였습니다. 어떤 입력 경로에서 분해형이 들어오는지는 여기서 확인하지 않았습니다.
브라우저와 서버의 숫자가 어긋나는 곳
같은 samples.json과, 앞에서 잘라 저장한 cut.json을 Python으로 읽었습니다.
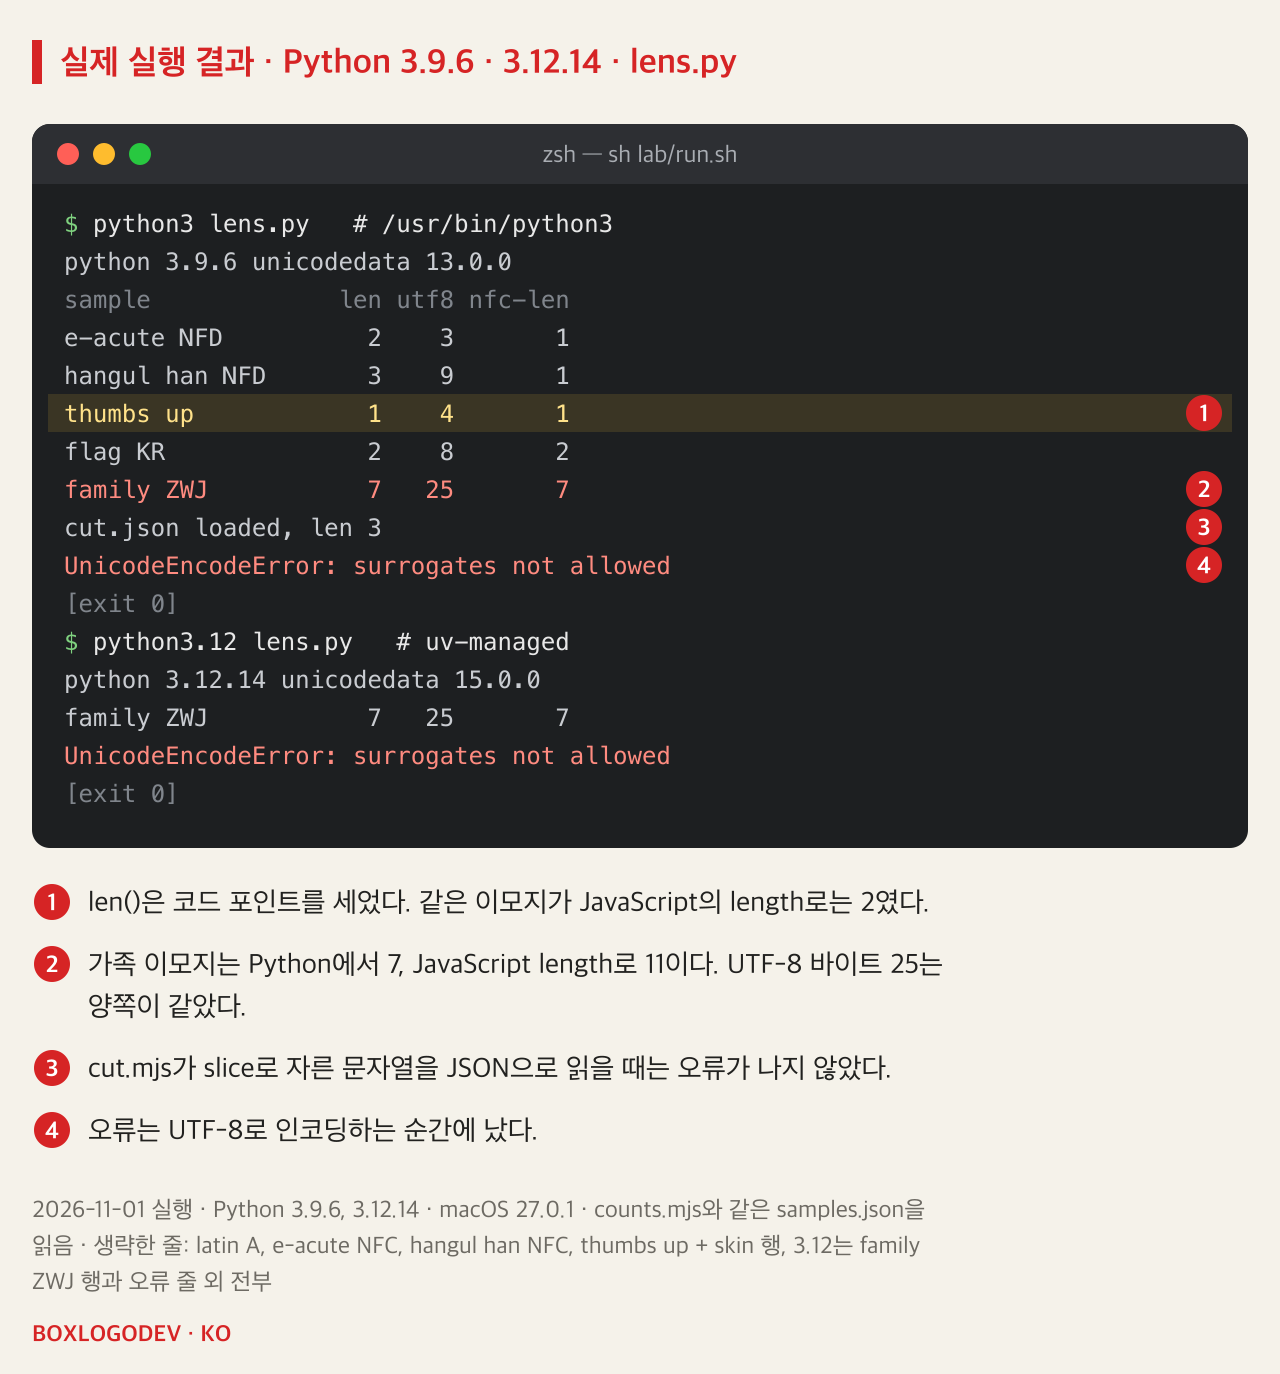
Python 문서는 문자열을 유니코드 코드 포인트의 시퀀스로 설명하고, 실행에서도 len()은 코드 포인트 수와 같았습니다. 가족 이모지는 JavaScript length로 11, Python len()으로 7입니다. 표의 값으로 따져 보면, 10자 제한을 양쪽에 이 두 방법으로 구현한 가상의 앱에서는 이 이모지가 브라우저 코드에서 거절되고 서버 코드에서는 통과합니다. 25바이트라는 값은 양쪽이 같았습니다.
HTML의 maxlength도 코드 유닛으로 잽니다. HTML 표준은 길이를 Infra의 length로 재고, Infra는 문자열을 코드 유닛의 연속으로 정의하며, MDN은 UTF-16 코드 유닛이라고 적습니다. MDN은 브라우저가 일반적으로 그 이상의 입력을 막는다고 설명하고, 표준의 '너무 김' 검사는 값이 사용자의 편집으로 마지막에 바뀌었을 때만 적용됩니다. 스크립트가 넣은 값에는 적용되지 않으니 서버 검사를 대신하지 못합니다. 이 단락은 문서로만 확인했고 브라우저에서 실행하지 않았습니다.
Python에서 그래핌을 세려면 문서상 3.15에 추가된 unicodedata.iter_graphemes()나 외부 패키지 regex의 \X가 있습니다. 둘 다 실행하지 않았고, 실행한 3.9.6과 3.12.14에는 앞의 함수가 없습니다.
무엇을 세는지부터 고른다
개발 노트
글자 수를 세기 전에 무엇을 셀지 고른다
같은 가족 이모지가 단위마다 다른 숫자가 된다
그래핌: 1
[...segmenter.segment(s)].length- 사람이 한 글자로 읽는 단위에 가깝다
- 화면의 글자 수 제한, 말줄임, 자르기에 쓴다
코드 포인트: 7
[...s].length- Python의 len()과 같은 값이었다
- 자르면 깨지지는 않아도 다른 글자가 될 수 있다
UTF-8 바이트: 25
encoder.encode(s).length- Node와 Python의 값이 같았다
- 바이트로 정한 저장·전송 제한에 쓴다
코드 유닛: 11
s.length- length, slice() 위치, HTML maxlength의 단위
- 글자 수로 읽으면 안 되는 숫자다
숫자는 2026-11-01 Node.js v24.21.0(ICU 78.3)과 Python 3.9.6·3.12.14 실행 결과다. maxlength는 HTML 표준과 MDN으로 확인했고 브라우저에서 실행하지 않았다. 용도 구분은 글쓴이의 정리다.
코드에서 length로 글자 수를 제한하거나 slice()로 자르는 줄을 찾아, 그 숫자가 화면의 글자 수인지 저장 바이트인지부터 적어 두세요. 사용자에게 보이는 제한과 자르기는 그래핌으로, 바이트로 정한 제한은 TextEncoder로, 문자열 비교 전에는 정규화로 나누면 위 실행에서 본 어긋남은 피할 수 있습니다. 이 구분은 실행 결과를 보고 정리한 글쓴이의 판단이며 표준 문서의 규칙은 아닙니다. 아주 긴 문자열에서 Intl.Segmenter의 속도는 재지 않았습니다.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…