거래처 목록 프로그램에서 테스트용 거래처를 빼려고 IF lv_name CS 'TEST'. CONTINUE. ENDIF.라고 썼습니다. 그런데 실제 거래처인 Contest Media GmbH가 목록에서 사라집니다. 이름 어디에도 대문자 TEST는 없는데 조건이 참이 된 것입니다. 이 글을 읽고 나면 CS와 CP가 대소문자를 가리지 않는다는 점과 그 이유, 같은 문자형 비교인데 대소문자를 가리는 연산자와 검색 문법이 무엇인지, 그리고 원래 의도한 조건을 코드에 정확히 적는 방법을 고를 수 있습니다.
예시의 lv_name은 TYPE c LENGTH 30이고, 거래처 이름 TEST VENDOR 01, Contest Media GmbH, Northwind Paper와 프로그램 ZDEMO_CS_CASE는 모두 지어낸 것입니다. 코드는 실제 시스템에서 실행하지 않았습니다. 글에 적은 결과는 ABAP 키워드 문서의 문자형 비교 연산자(7.50판, 7.54판과 7.58판 대조), FIND의 추가 문법, contains 함수 페이지의 규칙을 적용해 따진 값이며, 문서는 영어입니다.
CS는 대소문자를 가리지 않는다
CS(Contains String)는 오른쪽 피연산자의 내용이 왼쪽 피연산자 안에 들어 있으면 참입니다. 7.50판과 7.54판 문서는 이 비교가 대소문자를 가리지 않고, 왼쪽 피연산자의 뒤 공백은 따진다고 적습니다. 그래서 Contest Media GmbH의 넷째 글자부터 이어지는 소문자 test도 'TEST'와 같은 것으로 취급됩니다. 결과는 참이고, 시스템 필드 sy-fdpos에는 찾은 위치의 오프셋 3이 들어갑니다(첫 글자가 0입니다).
여기에는 문제가 두 가지 겹쳐 있습니다. 하나는 대소문자이고, 다른 하나는 위치입니다. CS는 글자열이 어디에 있든, 단어 한가운데 있든 상관하지 않습니다. 이름이 대문자로만 저장된 시스템이라면 CONTEST MEDIA GMBH도 같은 이유로 걸립니다. 비교가 거짓이면 sy-fdpos에는 오프셋 대신 왼쪽 피연산자의 길이가 들어가므로, 거짓일 때 sy-fdpos를 위치로 읽으면 안 됩니다.
SAP 노트
CS 'TEST'를 세 이름에 걸어 보면
가상 예: lv_name은 TYPE c LENGTH 30, 조건은 IF lv_name CS 'TEST'
TEST VENDOR 01
'TEST VENDOR 01' CS 'TEST'- 맨 앞에 TEST가 있다
- 결과: 참
- sy-fdpos = 0
Contest Media GmbH
'Contest Media GmbH' CS 'TEST'- 소문자 test가 단어 안에 있다
- CS는 대소문자를 가리지 않는다
- 결과: 참, sy-fdpos = 3
Northwind Paper
'Northwind Paper' CS 'TEST'- test라는 글자열이 없다
- 결과: 거짓
- sy-fdpos = 왼쪽 피연산자의 길이
이름과 변수는 가상입니다. 결과는 ABAP 키워드 문서(7.50·7.54판)의 CS 규칙으로 따진 값이며 실행 결과가 아닙니다.
오른쪽 피연산자의 공백으로 단어 경계를 흉내 내려는 시도도 통하지 않습니다. 문서는 따로 적지 않은 한 c, d, n, t 타입 피연산자의 뒤 공백은 따지지 않는다고 하고, CS에서 뒤 공백을 따지는 것은 왼쪽 피연산자뿐입니다. 규칙대로라면 작은따옴표 리터럴 'TEST '는 'TEST'와 똑같이 동작합니다. 문서에는 하나 더 적힌 경우가 있습니다. 왼쪽이 공백만 든 c 필드나 빈 string이면 결과는 거짓이지만, 오른쪽도 그렇게 비어 있으면 결과는 항상 참입니다. 검색어 변수를 CS의 오른쪽에 둘 때는 둘 다 빈 경우를 먼저 걸러야 합니다.
같은 비교 연산자라도 CO와 CA는 대소문자를 가린다
문자형 비교 연산자 여덟 개가 모두 같은 규칙을 따르지는 않습니다. CO(이 글자들로만 이루어짐)와 CA(이 글자 중 하나라도 있음)는 대소문자를 가리고, 두 피연산자의 뒤 공백도 따집니다. CN과 NA는 각각 CO와 CA의 부정입니다. 반대로 CS와 그 부정 NS, 패턴 비교 CP와 그 부정 NP는 대소문자를 가리지 않습니다. 같은 'abc'를 두고도 'abc' CS 'B'는 참, 'abc' CA 'B'는 거짓입니다.
CP에는 대소문자를 가리게 하는 장치가 있습니다. 패턴에서 *는 빈 글자열을 포함한 아무 글자열, +는 아무 한 글자이며, 글자 앞에 이스케이프 문자 #을 붙이면 그 글자는 대소문자를 가려서 그대로 비교합니다. +는 빈 글자열을 뜻하지 않는다는 점, 그리고 CP는 '패턴을 포함한다'가 아니라 '패턴에 들어맞는다'는 뜻이라 문자열 전체가 패턴과 맞아야 한다는 점도 문서에 적혀 있습니다. 문서의 예제가 태그를 찾으려고 '<*>'가 아니라 '*<*>*'를 쓰는 이유입니다.
검색 문법은 기본값이 반대입니다. FIND는 RESPECTING CASE나 IGNORING CASE를 적지 않으면 RESPECTING CASE로 동작해 대소문자를 가립니다. 내장 함수 contains( )와 find( )도 기본으로 대소문자를 가리고, case = abap_false를 넘겨야 가리지 않습니다. '포함하는지 본다'는 같은 의도인데, CS는 가리지 않고 FIND와 contains( )는 가리는 셈입니다.
SAP 노트
대소문자를 가리는 것과 가리지 않는 것
문자형 비교 연산자와 검색 문법의 기본 동작
가리지 않음
'abc' CS 'B' → true- CS · NS: 글자열 포함 여부
- CP · NP: 패턴 일치(* +)
- #을 붙인 글자만 대소문자 구분
가림
'abc' CA 'B' → false- CO · CN: 이 글자들로만 이루어짐
- CA · NA: 이 글자 중 하나라도
- 두 피연산자의 뒤 공백도 따진다
기본값이 가림
FIND 'B' IN 'abc' → sy-subrc 4- FIND: RESPECTING CASE가 기본
- contains( ), find( ): case 기본 구분
- IGNORING CASE, case = abap_false로 끔
ABAP 키워드 문서의 비교 연산자, FIND, contains, string_func - case 페이지 기준입니다. 코드 예시의 결과는 규칙으로 따진 값입니다.
원하는 조건을 그대로 코드에 적기
해결의 출발점은 '테스트 거래처'가 무엇인지 정하는 것입니다. 예시에서는 'TEST와 공백으로 시작하는 이름'이라고 정했다고 합시다. 그러면 세 가지 쓰기를 같은 이름 세 개에 적용해 비교할 수 있습니다.
첫째, FIND 'TEST' IN lv_name.으로 바꾸면 Contest Media GmbH는 더 이상 걸리지 않고, 찾지 못했으므로 sy-subrc가 4입니다. 하지만 위치 문제는 그대로라 대문자 CONTEST는 여전히 찾습니다. 대소문자만 해결된 것입니다. 문서는 FIND와 검색 함수가 CS보다 훨씬 빠를 수 있다고도 적으므로, 긴 루프 안이라면 바꿀 이유가 하나 더 있습니다.
둘째, contains( val = lv_name start = `TEST` )는 맨 앞의 일치만 보고 대소문자를 가립니다. 다만 TESTA처럼 바로 뒤에 글자가 붙은 이름은 거르지 못합니다. 셋째, lv_name CP '#T#E#S#T *'는 네 글자 모두에 #을 붙여 대문자 TEST만 받고, 그 뒤의 공백까지 요구합니다. 규칙대로라면 세 이름 가운데 TEST VENDOR 01만 참입니다.
SAP 노트
TEST로 시작하는 이름만 고르려면
같은 가상 이름 세 개에 세 가지 쓰기를 적용한 결과
FIND로 바꾸기
FIND 'TEST' IN lv_name.- Contest Media GmbH: 못 찾음
- 대문자 CONTEST라면 여전히 찾음
- 대소문자만 해결된다
contains( start = )
contains( val = lv_name start = `TEST` )- 맨 앞의 TEST만 본다
- 대소문자 구분이 기본
- TESTA처럼 붙은 글자는 못 거름
CP에 # 붙이기
lv_name CP '#T#E#S#T *'- #T#E#S#T: 대문자 TEST만
- 뒤의 공백까지 요구한다
- TEST VENDOR 01만 참
이름은 가상이고 코드는 실행하지 않았습니다. 결과는 문서의 FIND, contains, CP 규칙으로 따진 값입니다. contains( )는 ABAP 7.0 EhP2부터 있습니다.
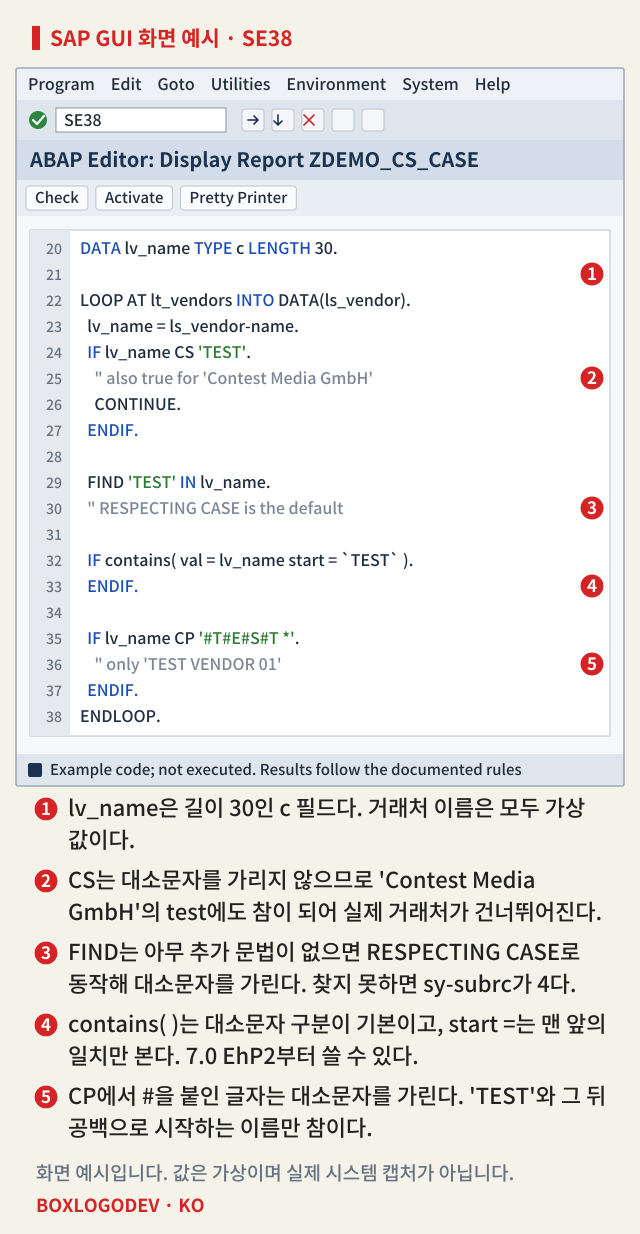
아래 편집기 예시는 이 흐름을 한 화면에 모은 것입니다. ①은 선언, ②는 실제 거래처를 건너뛰는 CS 줄, ③은 대소문자를 가리는 FIND, ④는 맨 앞만 보는 contains( ), ⑤는 #을 붙인 CP입니다. 기존 코드에서 CS나 CP 뒤에 대문자 리터럴이 있으면, 작성자가 대소문자 구분을 기대했는지 한 번 확인할 만합니다.
문서 문구가 판마다 다르다
릴리스에 따른 차이는 동작보다 문서 쪽에서 먼저 보입니다. 7.50판과 7.54판 영어 문서는 CS가 대소문자를 가리지 않는다고 분명히 적고, 7.54판 독일어 문서도 대소문자는 따지지 않고 왼쪽 피연산자의 뒤 공백은 따진다고 적습니다. 그런데 7.57판과 7.58판 영어 문서의 CS 문장은 '대문자와 소문자, 그리고 왼쪽 피연산자의 뒤 공백을 따진다'로 읽히게 바뀌었습니다. 같은 7.58판 페이지의 CP 항목은 여전히 대소문자를 가리지 않는다고 적고, CS 예제는 소문자 알파벳 문자열에서 'H'의 위치를 보여 주는 예로 설명됩니다. 이 예제는 대소문자를 가리지 않아야 뜻이 통합니다.
문서 문구만으로는 어느 쪽이 맞는지 단정할 수 없고, 이 글은 실제 시스템에서 확인하지 않았습니다. 그러니 쓰는 시스템에서 IF 'abc' CS 'B'. 한 줄로 직접 확인해 보는 편이 확실합니다. 참이면 이 글의 설명대로 동작하는 것이고, 그때 sy-fdpos는 1입니다. contains( )와 find( ) 같은 문자형 함수는 ABAP 7.0 EhP2에서 들어왔으므로, 그보다 오래된 시스템에서는 FIND나 #을 붙인 CP가 쓸 수 있는 방법입니다.
기억할 것은 하나입니다. CS로 '포함'을 검사하면 대소문자와 단어 경계를 모두 무시합니다. 대소문자를 가려야 하거나 위치가 중요하다면, 그 조건을 FIND, contains( ), #을 붙인 CP로 코드에 직접 적으세요.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…