내부 테이블에서 중복을 지우려고 DELETE ADJACENT DUPLICATES를 썼는데 같은 공급업체가 여전히 두 번 나오거나, 반대로 금액이 다른 행까지 사라져 합계가 줄어드는 경우가 있습니다. 둘 다 문법 오류도 런타임 오류도 아니고, 문서에 적힌 대로 동작한 결과입니다. 이 글을 읽고 나면 이 문장이 무엇을 "중복"으로 보는지 세 가지 질문, 곧 어떤 행끼리 비교하는가, 어떤 열을 비교하는가, 어느 행을 남기는가로 나눠 확인하고 코드를 고칠 수 있습니다.
예시는 가상 구조 ty_item입니다. 공급업체 lifnr, 전표 번호 belnr, 전기일 budat, 금액 dmbtr(p형) 네 열이고, 공급업체 V-0001과 V-0002의 다섯 행이 읽힌 순서대로 V-0002, V-0001, V-0001, V-0002, V-0001이라고 합시다. V-0001의 두 번째·세 번째 행은 같은 전표 5100000001, 같은 전기일 2026-09-01에 금액만 300.00과 200.00으로 다릅니다. 테이블, 공급업체, 금액은 모두 지어낸 값이고 코드는 실제 시스템에서 실행하지 않았습니다. 동작의 근거는 ABAP 키워드 문서의 DELETE itab, duplicates와 관련 항목(7.58판, 7.50판)이며, 문서 본문은 영어입니다.
바로 앞 행과만 비교한다
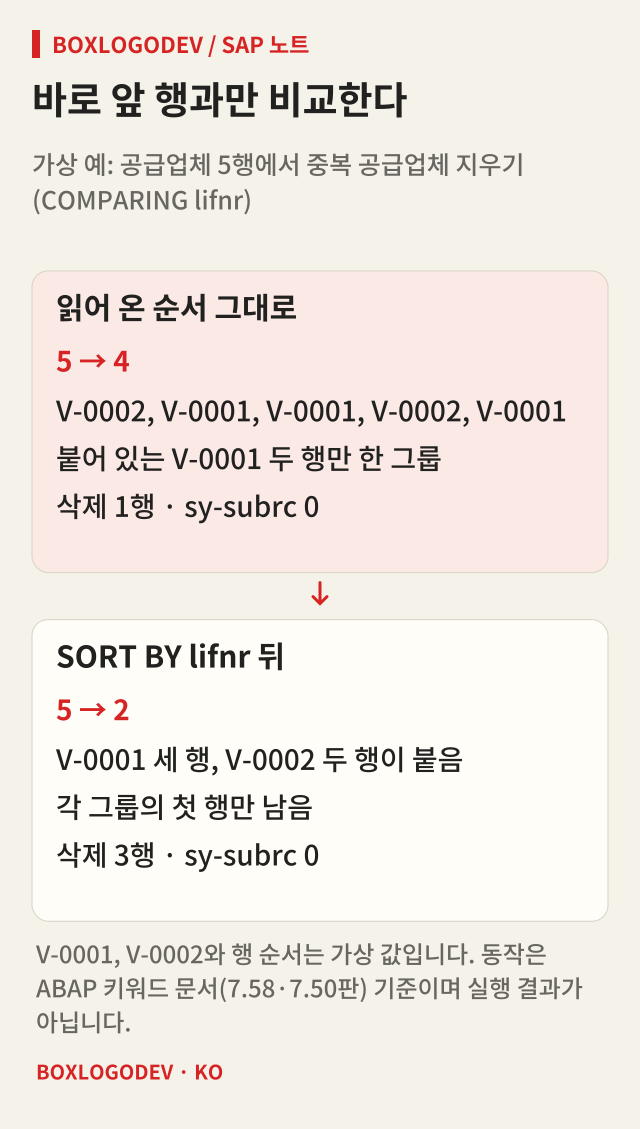
이름의 ADJACENT가 핵심입니다. 이 문장은 연속해서 붙어 있고 비교하는 열의 값이 같은 행들을 한 그룹으로 묶고, 그룹마다 첫 행만 남기고 나머지를 지웁니다. 테이블 전체에서 같은 값을 찾아 주지 않습니다. 떨어져 있는 같은 값은 서로 다른 그룹입니다.
공급업체 목록을 만들려고 위 다섯 행에 COMPARING lifnr만 붙여 지우면, 붙어 있는 V-0001 두 행만 한 그룹이 되어 한 행이 지워지고 네 행이 남습니다. V-0001과 V-0002가 여전히 두 번씩 나옵니다. 먼저 SORT ... BY lifnr로 정렬하면 V-0001 세 행과 V-0002 두 행이 각각 붙어 세 행이 지워지고 두 행이 남습니다. 문서도 이 문장은 대개 비교하는 열 기준의 알맞은 정렬이 필요하다고 적습니다.
반환 코드로는 이 차이를 알 수 없습니다. sy-subrc는 한 행이라도 지워지면 0, 지울 중복을 찾지 못하면 4입니다. 위 두 경우 모두 0이므로, 0은 "중복이 모두 없어졌다"가 아니라 "적어도 한 행을 지웠다"는 뜻일 뿐입니다. sy-tabix는 설정되지 않습니다.
COMPARING을 빼면 무엇을 비교할까
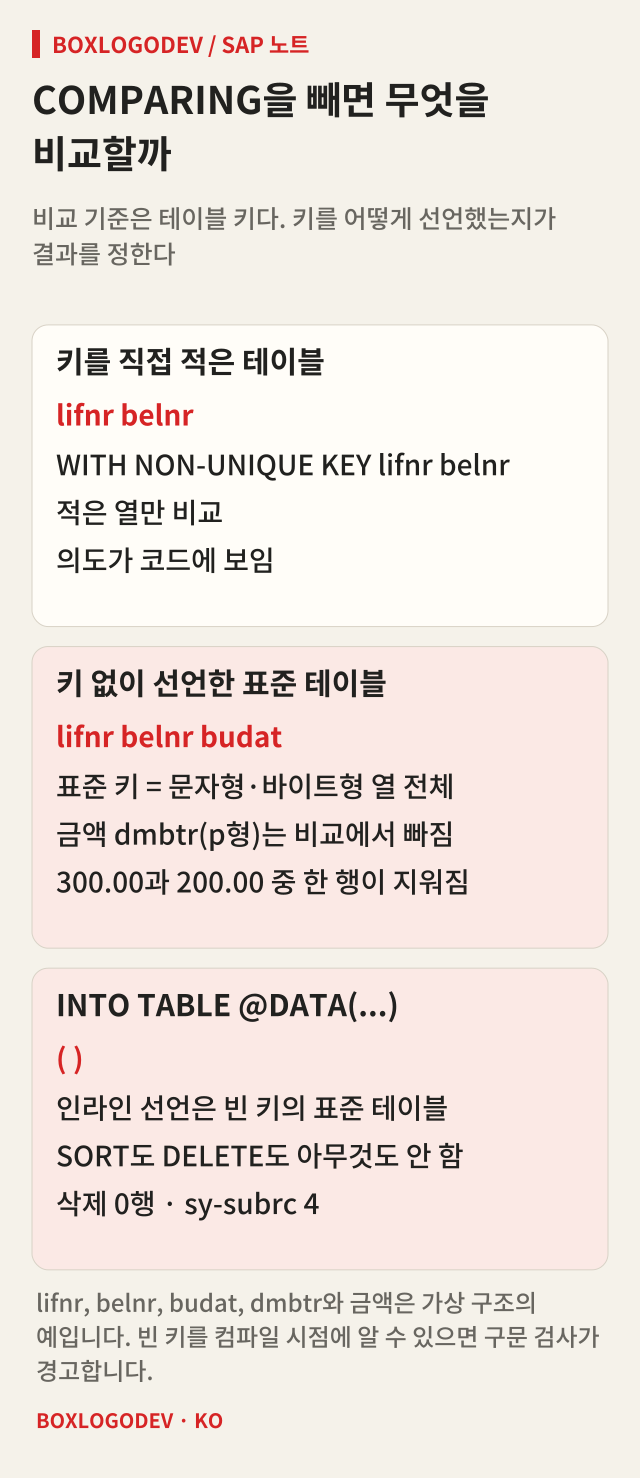
COMPARING을 적지 않으면 그룹은 사용하는 테이블 키의 키 필드로 정해지고, 키를 따로 지정하지 않으면 기본 테이블 키가 쓰입니다. 그래서 테이블을 어떻게 선언했는지가 결과를 정합니다. 키를 WITH NON-UNIQUE KEY lifnr belnr처럼 직접 적었다면 적은 열만 비교하므로 의도가 코드에 그대로 보입니다.
문제는 DATA lt_items TYPE STANDARD TABLE OF ty_item.처럼 키 없이 선언한 표준 테이블입니다. 이때 기본 키는 표준 키이고, 구조형 행의 표준 키는 문자형과 바이트형 열 전체입니다. 날짜형 d와 시간형 t도 특수한 문자형이므로 lifnr, belnr, budat는 키에 들어가고, p형 금액 dmbtr는 빠집니다. 정렬한 뒤 COMPARING 없이 지우면 금액만 다른 300.00과 200.00 두 행이 중복으로 판정되어 한 행이 사라집니다. V-0001 합계 620.00이 420.00이나 320.00으로 줄어드는데, 어느 쪽이 될지는 다음 절에서 보듯 정렬에 달려 있습니다. 문서가 표준 키를 쓰면 예상하지 못한 결과가 생길 수 있다고 경고하는 이유가 이것입니다.
반대 방향의 함정도 있습니다. SELECT ... INTO TABLE @DATA(lt_raw)로 인라인 선언한 테이블은 키가 비어 있는 표준 테이블입니다. 키가 비어 있으면 키 기준 SORT lt_raw.는 정렬을 하지 않고, COMPARING 없는 DELETE ADJACENT DUPLICATES는 한 행도 지우지 않습니다. sy-subrc는 4입니다. 컴파일 시점에 빈 키임을 알 수 있으면 구문 검사가 두 문장 모두에 경고를 내므로, 이 경고는 무시하지 말아야 할 신호입니다.
어느 행이 남는지는 정렬이 정한다
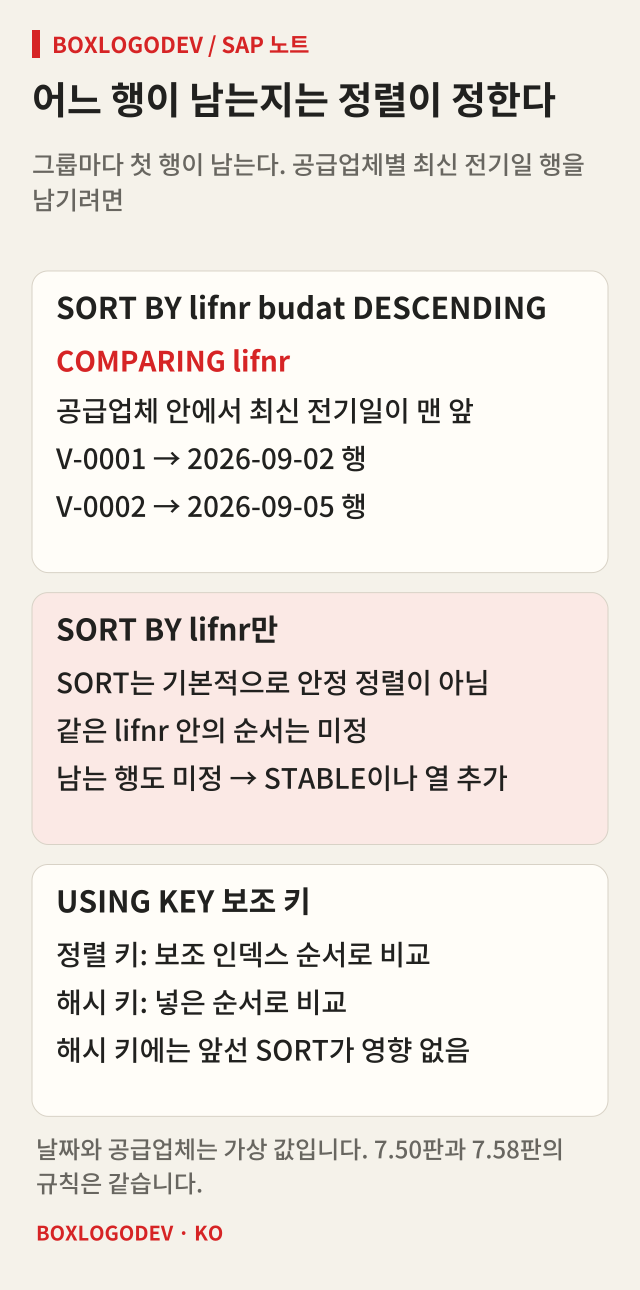
그룹에서 남는 것은 항상 첫 행입니다. 그러니 어떤 행을 남길지는 앞선 정렬로 정합니다. 공급업체마다 가장 최근 전기일의 행 하나를 남기려면 SORT lt_items BY lifnr ASCENDING budat DESCENDING. 뒤에 COMPARING lifnr로 지웁니다. 가상 예에서는 V-0001의 2026-09-02 행(전표 5100000002, 120.00)과 V-0002의 2026-09-05 행(80.00)이 남습니다.
SORT ... BY lifnr만 하면 같은 공급업체 안에서 어느 행이 앞에 올지 정해지지 않습니다. SORT는 기본적으로 안정 정렬이 아니어서 정렬 키가 같은 행끼리의 원래 순서를 지키지 않고, 문서에 따르면 플랫폼이나 정렬 횟수에 따라 순서가 달라질 수 있습니다. 앞 절에서 300.00과 200.00 중 어느 행이 남을지 말할 수 없었던 이유도 같습니다. 읽어 온 순서를 지키려면 STABLE을 붙이고, 의미 있는 기준이 있으면 정렬 열을 더합니다.
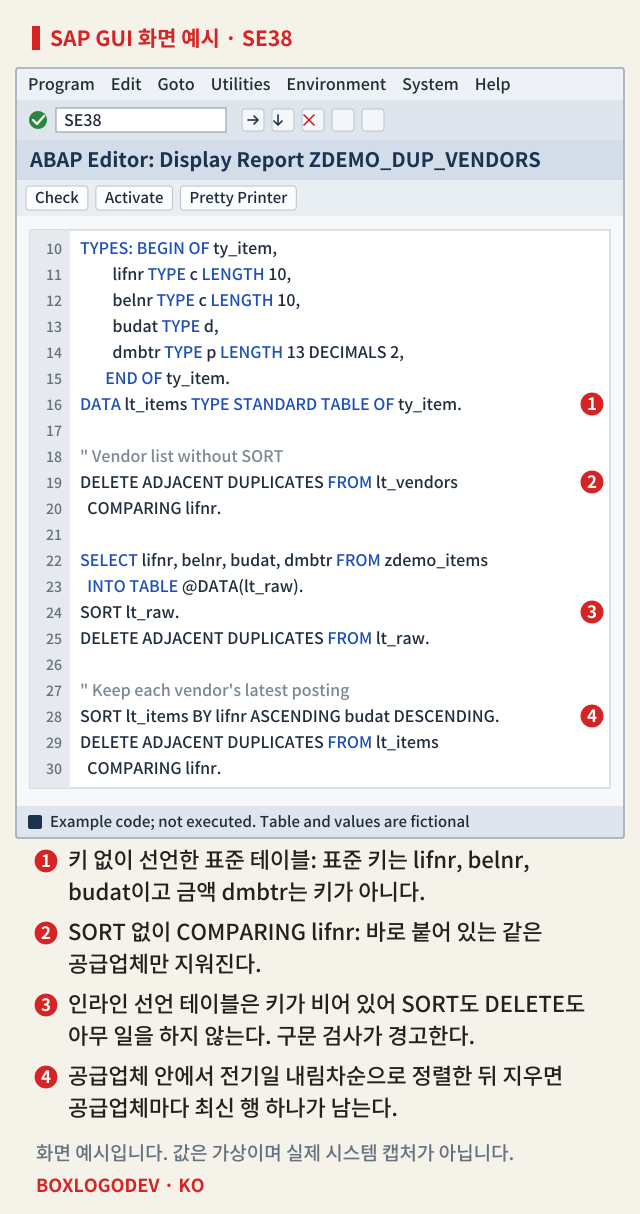
위 화면의 번호를 코드 점검 순서로 읽으면 이렇습니다. 1번은 키 없이 선언한 표준 테이블로, 금액이 키에서 빠집니다. 2번은 정렬 없는 COMPARING lifnr라서 붙어 있는 값만 지웁니다. 3번은 인라인 선언 테이블이라 SORT와 DELETE가 모두 아무 일도 하지 않습니다. 4번은 비교할 열과 남길 행을 정렬로 함께 정한 고친 코드입니다.
보조 키와 릴리스
USING KEY로 보조 키를 지정하면 비교 순서가 달라집니다. 정렬 보조 키는 보조 테이블 인덱스의 행 번호 순서로 처리하므로 따로 SORT를 하지 않아도 그 키 기준으로 붙은 중복이 지워집니다. 해시 보조 키는 행을 넣은 순서로 처리하고, 앞선 SORT는 이 순서에 영향을 주지 않습니다. 기본 키로 해시 테이블을 처리할 때와 다른 점이라 문서도 따로 짚습니다. 정렬 테이블은 이미 키 순서로 놓여 있으므로 COMPARING 없이 지우면 키가 같은 행이 정리됩니다. 정렬 테이블과 해시 테이블은 빈 표준 키를 가질 수 없습니다.
이 글에서 다룬 규칙, 곧 인접한 행만 비교한다는 점, COMPARING이 없을 때 키를 쓰는 방식, 표준 키의 구성, 빈 키에서 아무것도 지우지 않는 동작, USING KEY의 처리 순서, sy-subrc의 의미, 인라인 선언 테이블의 빈 키는 7.50판과 7.58판 문서에 같은 내용으로 있습니다. 7.58판에는 의사 구성 요소 table_line을 COMPARING에 적으면 ALL FIELDS와 같다는 힌트가 더해졌고, 예제 코드가 바뀌었습니다. 자기 시스템의 릴리스에 맞는 판을 한 번 확인해 두세요.
코드에서 확인할 세 가지
기존 프로그램의 DELETE ADJACENT DUPLICATES마다 세 가지를 확인합니다. 첫째, 바로 앞에 비교할 열 순서대로 SORT가 있는가, 또는 그 순서를 보장하는 정렬 키를 USING KEY로 쓰는가. 둘째, COMPARING이 빠졌다면 그 테이블의 키가 무엇인가. 키 없이 선언한 표준 테이블이나 인라인 선언 테이블이라면 COMPARING에 열을 직접 적습니다. 셋째, 같은 그룹에서 어느 행이 남아야 하는지 정렬 기준에 적혀 있는가.
하나만 기억한다면 이것입니다. 이 문장의 중복은 "붙어 있고, 비교하는 열이 같은 행"입니다. 무엇을 붙여 놓을지와 무엇을 비교할지를 코드에 직접 적으세요.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…