ORDER BY 없이 읽은 SELECT의 결과는 어떤 순서로도 약속되지 않습니다. 개발 시스템에서 매번 키 순서로 나왔더라도, 그것은 그때 그렇게 나왔을 뿐 보장이 아닙니다. 이 글을 읽고 나면 코드에서 순서에 기대는 세 자리, 곧 키를 다 적지 않은 SELECT SINGLE, ORDER BY 없는 UP TO n ROWS, 정렬하지 않은 테이블에 쓴 BINARY SEARCH를 찾아 고칠 수 있습니다.
예시는 가상 가격 테이블 ZPRICE_DEMO입니다. 키는 클라이언트, 자재(material), 유효 시작일(valid_from)이고, 자재 Z-100에 2026-01-01부터 1,000, 2026-07-01부터 1,100, 2026-10-01부터 1,150이라는 세 행이 있다고 합시다. 테이블과 값은 모두 지어낸 것이고 코드는 실제 시스템에서 실행하지 않았습니다. 동작의 근거는 ABAP 키워드 문서의 SELECT, ORDER BY와 관련 항목(7.58판, 7.50판)이며, 문서 본문은 영어입니다.
ORDER BY가 없으면 무엇이 정해지지 않을까
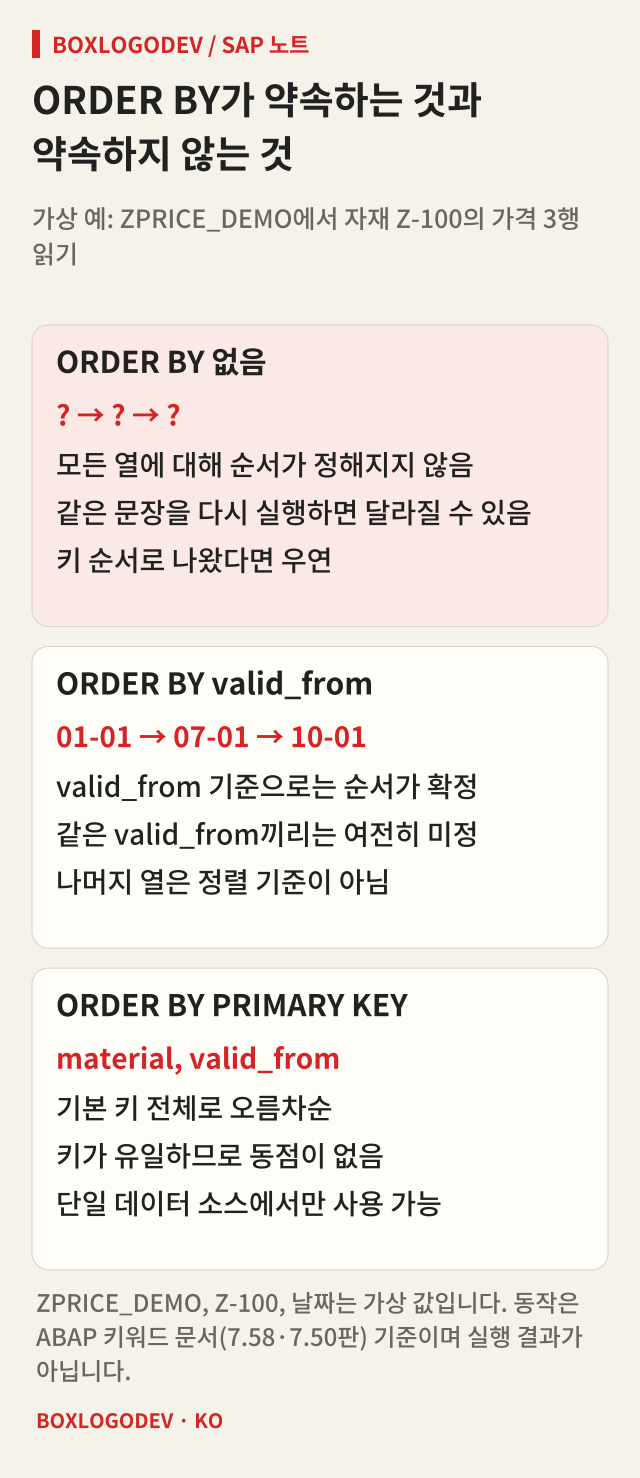
문서의 문장은 분명합니다. ORDER BY를 적지 않으면 결과 집합의 행 순서는 모든 열에 대해 정해지지 않습니다. ORDER BY를 적어도 순서가 정해지는 것은 거기에 적은 열뿐이고, 적지 않은 열에 대해서는 여전히 미정이며 같은 SELECT를 다시 실행하면 달라질 수 있다고 덧붙입니다.
그래서 ORDER BY valid_from은 세 행을 01-01, 07-01, 10-01 순서로 확정하지만, 같은 valid_from을 가진 행이 여러 개라면 그 행들끼리의 순서는 약속하지 않습니다. 동점이 없게 하려면 행을 유일하게 구별하는 열까지 정렬 기준에 넣거나, 단일 테이블이라면 ORDER BY PRIMARY KEY를 씁니다. 기본 키는 유일하므로 동점이 생기지 않습니다. 다만 PRIMARY KEY는 조인이나 경로 식으로 여러 소스를 읽을 때, UNION·INTERSECT·EXCEPT로 합친 결과, 하위 쿼리 안에서는 쓸 수 없습니다.
정렬은 데이터베이스에서 WHERE, 집계, GROUP BY가 모두 끝난 뒤에 일어나고, UP TO와 OFFSET은 정렬된 결과에 적용됩니다. 이 순서가 다음 절의 핵심입니다.
SELECT SINGLE은 어느 행을 돌려줄까
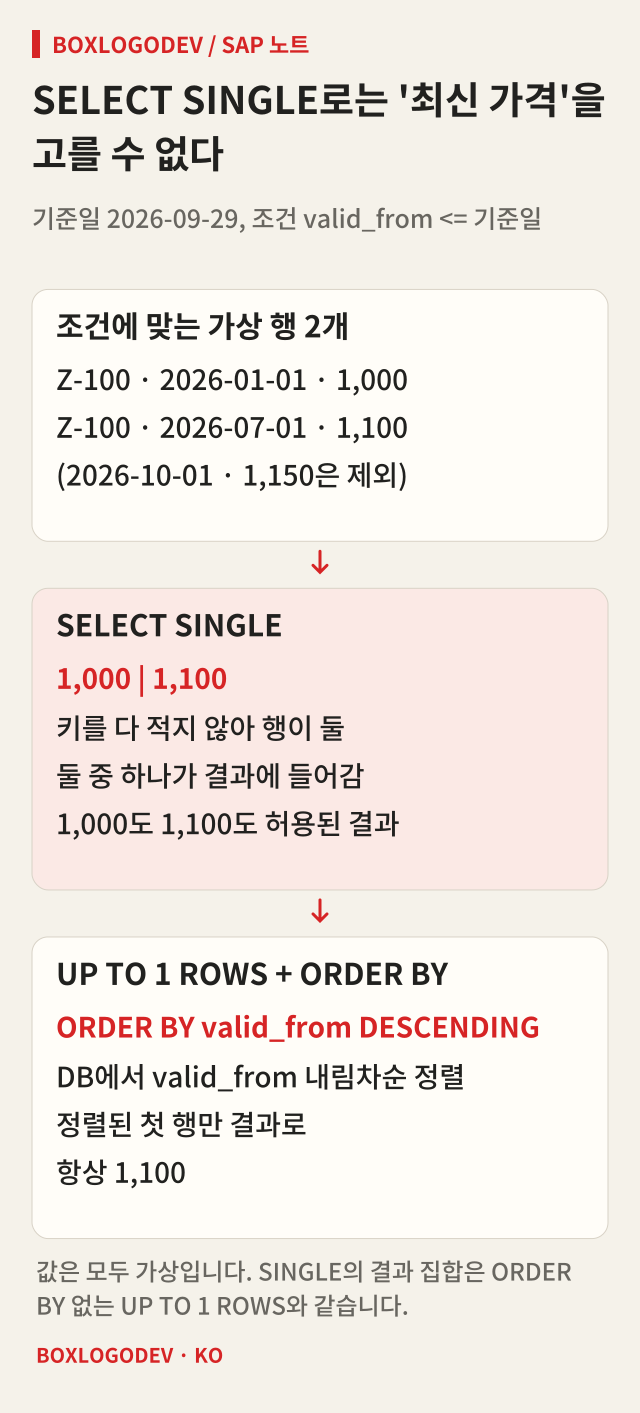
기준일 2026-09-29의 Z-100 가격을 읽는다고 합시다. 조건 valid_from <= 기준일에 맞는 행은 1,000과 1,100 두 개입니다. 여기에 SELECT SINGLE을 쓰면 문서가 말하는 경우에 해당합니다. 선택이 여러 행을 덮으면 그중 한 행이 결과에 들어갑니다. 7.50판은 이를 "무작위로"라고까지 적었습니다. 1,000이 와도 1,100이 와도 문서상 올바른 동작입니다.
SINGLE에는 ORDER BY를 붙일 수 없습니다. 그래서 문서는 여러 행 중 어느 행을 읽을지 정해야 하면 UP TO 1 ROWS와 ORDER BY를 함께 쓰라고 권합니다. ORDER BY valid_from DESCENDING으로 정렬한 뒤 첫 행만 받으면 결과는 항상 1,100입니다. 권고를 한 줄로 줄이면, 키를 모두 적어 정확히 한 행을 읽을 때는 SINGLE, 여러 행 중 최대 한 행을 읽을 때는 UP TO 1 ROWS입니다. 둘의 성능 차이는 실무에서 대개 무시해도 된다고 문서는 설명합니다.
UP TO 1 ROWS로 구조에 읽으면 루프가 열리므로 ENDSELECT가 필요하고, 내부 테이블로 받으면 필요 없습니다. 키를 다 적지 않은 SELECT SINGLE에는 확장 프로그램 검사가 경고를 냅니다. 행이 있는지 확인하는 용도라면 어느 행이 오든 상관없으므로 문서가 허용하는 대로 프래그마로 경고를 숨기고 써도 됩니다. 값을 쓰는 코드라면 그 경고는 고칠 곳을 알려 주는 신호입니다.
UP TO n ROWS와 BINARY SEARCH도 순서에 기댄다
ORDER BY 없는 UP TO n ROWS는 조건에 맞는 행 중 임의의 n행을 돌려줍니다. "최근 3건"이나 "상위 10건"을 뜻했다면 ORDER BY가 빠진 순간 의미가 사라집니다. ORDER BY가 있어도 정렬 기준이 유일하지 않으면 경계에 걸린 동점 행 중 어느 것이 결과에 들어갈지 정할 수 없습니다. 페이지를 나누는 OFFSET은 아예 ORDER BY 없이는 쓸 수 없고, 문서는 순서가 정해져 있을 때만 의미가 있다고 적습니다. 페이지 사이에 행이 빠지거나 겹치지 않으려면 정렬 기준에 키 열을 끝까지 넣습니다.
두 번째 함정은 ABAP 쪽에 있습니다. ORDER BY 없이 INTO TABLE로 받은 표준 테이블에 READ TABLE ... BINARY SEARCH를 쓰는 경우입니다. 이진 검색은 테이블이 검색 키 구성 요소 순서대로 오름차순 정렬되어 있다고 전제하고, 그렇지 않으면 문서 표현대로 대개 올바른 행을 찾지 못합니다. 오류가 나는 것이 아니라 sy-subrc 4나 엉뚱한 행이 조용히 돌아옵니다. 읽은 뒤 SORT를 하거나, 정렬 테이블이나 정렬된 보조 키를 씁니다.
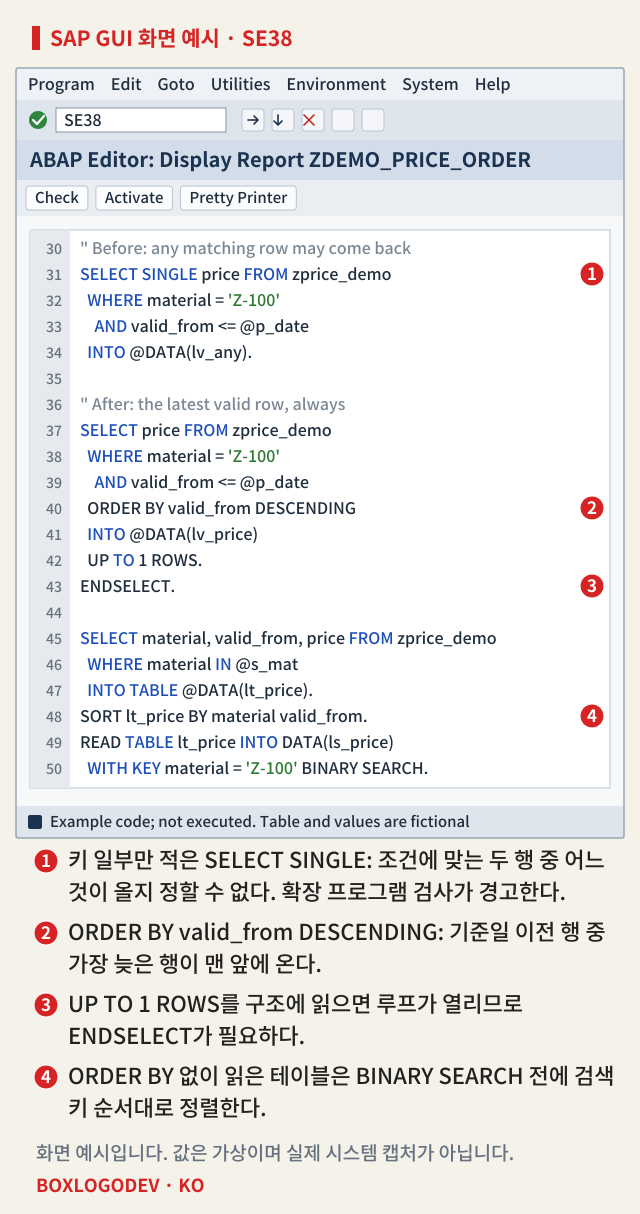
정렬을 어디서 할지도 문서가 짚습니다. 데이터베이스 정렬이 인덱스로 뒷받침된다고 보장되는 것은 ORDER BY PRIMARY KEY뿐이고, 알맞은 인덱스가 없으면 데이터베이스에서 ORDER BY를 하기보다 AS ABAP에서 SORT를 하라고 권합니다. 위 화면의 네 번째 번호가 그 경우입니다. 한 가지 더, 검색 키가 유일하지 않을 때 BINARY SEARCH는 맞는 행 중 행 번호가 가장 작은 행을 돌려줍니다. 위 예에서는 가장 이른 valid_from의 행입니다. 최신 행이 필요하면 정렬 방향까지 함께 설계해야 합니다.
릴리스에 따라 달라지는 부분
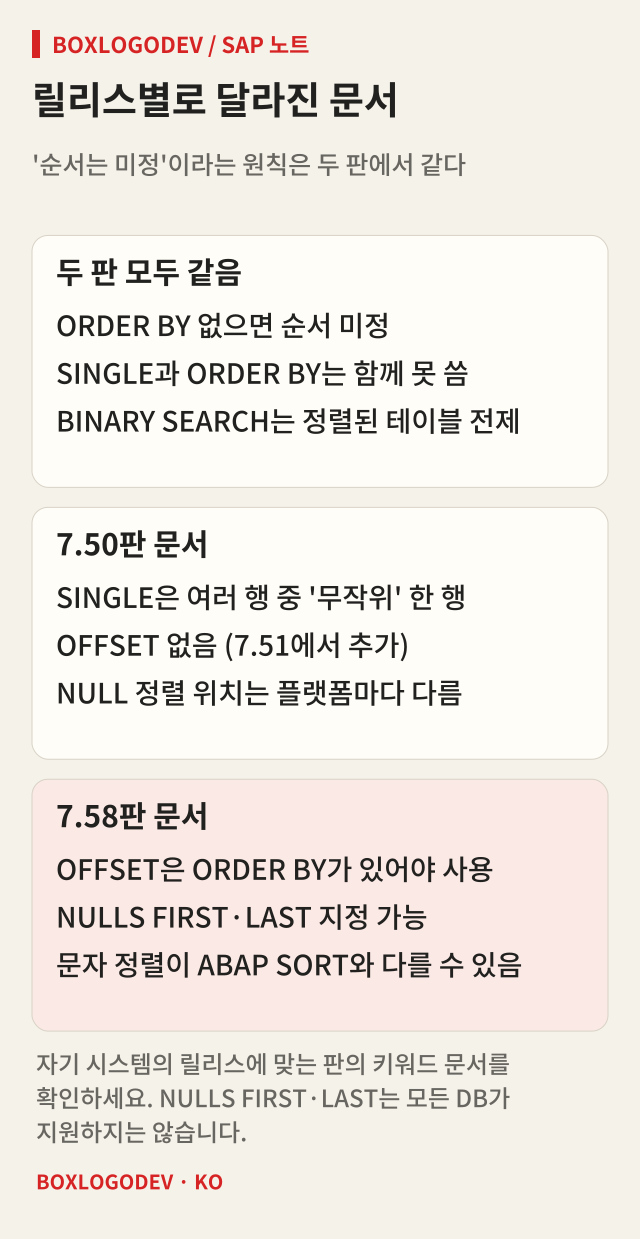
"ORDER BY가 없으면 순서는 미정"이라는 원칙, SINGLE과 ORDER BY를 함께 쓸 수 없다는 제한, BINARY SEARCH가 정렬을 전제한다는 설명은 7.50판과 7.58판에 똑같이 있습니다.
달라진 것은 순서에 기대는 기능입니다. OFFSET은 7.51에서 추가되었으므로 7.50 시스템에는 없습니다. 7.50판은 ORDER BY 열에 NULL이 있으면 정렬 위치가 플랫폼마다 다를 수 있다고만 적었고, 7.58판에는 NULLS FIRST와 NULLS LAST가 있습니다. 이 추가 구문은 모든 데이터베이스가 지원하지는 않습니다. 7.58판은 또 문자형 값의 데이터베이스 정렬이 플랫폼에 따라 ABAP SORT와 다른 결과를 낼 수 있다고 경고합니다. 데이터베이스에서 정렬해 받은 테이블이라도 BINARY SEARCH 전에 ABAP에서 다시 정렬하는 편이 안전한 이유입니다. SELECT, SINGLE 항목을 포함해 자기 시스템의 릴리스에 맞는 판을 확인하세요.
코드에서 확인할 세 가지
기존 프로그램을 점검한다면 세 가지를 찾습니다. 첫째, 키를 다 적지 않은 SELECT SINGLE이 값을 읽는 데 쓰이는가. 그렇다면 UP TO 1 ROWS와 ORDER BY로 바꿉니다. 둘째, UP TO n ROWS나 OFFSET에 붙은 ORDER BY가 행을 유일하게 정렬하는가. 셋째, BINARY SEARCH 앞에 같은 키 순서의 SORT가 있는가.
하나만 기억한다면 이것입니다. 순서가 필요하면 순서를 적어야 합니다. 적지 않은 순서는 오늘 맞아도 내일은 약속되지 않습니다.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…