메뉴 이름마다 처리 함수를 반복문으로 만들었는데 어느 메뉴를 불러도 마지막 메뉴가 실행된다면, 함수가 값을 붙들고 있다고 가정한 곳부터 봐야 합니다. Python의 함수는 바깥 이름을 부를 때 읽습니다. 이 글을 읽고 나면 왜 전부 같은 값이 나오는지 설명하고, 기본 인자, 팩토리 함수, partial 중 어느 쪽으로 고칠지 정할 수 있습니다.
예제는 2026-11-01에 macOS 27.0.1에서 CPython 3.9.6, 3.11.17, 3.12.14로 실행했고, 세 버전의 출력은 뒤에 나오는 정렬하지 않은 스레드 줄을 빼면 같았습니다. 그림의 출력은 3.9.6입니다. 동작은 Python 3.15.2 문서(2026-10-31 갱신판)로 확인했으며 3.13 이후 버전은 실행하지 않았습니다. 메뉴 이름과 값은 모두 가상입니다.
함수는 값이 아니라 이름을 찾는다
handlers = {}
for name in ["save", "load", "quit"]:
    handlers[name] = lambda: f"run {name}"

print(handlers["save"]())
print(handlers["load"]())
print(handlers["quit"]())
세 줄 모두 run quit이 나왔습니다. lambda 안의 name은 함수를 만들 때 계산되지 않습니다. Python FAQ도 같은 사례를 들며, 그 변수는 정의할 때가 아니라 호출할 때 읽힌다고 설명합니다. 실행 모델 문서도 자유 변수의 이름 해석은 실행 중에 일어난다고 적습니다. 세 번 부르는 시점에 반복은 이미 끝났고, for 문은 끝난 뒤에도 대상 이름을 지우지 않으므로 name에는 "quit"이 남아 있습니다.
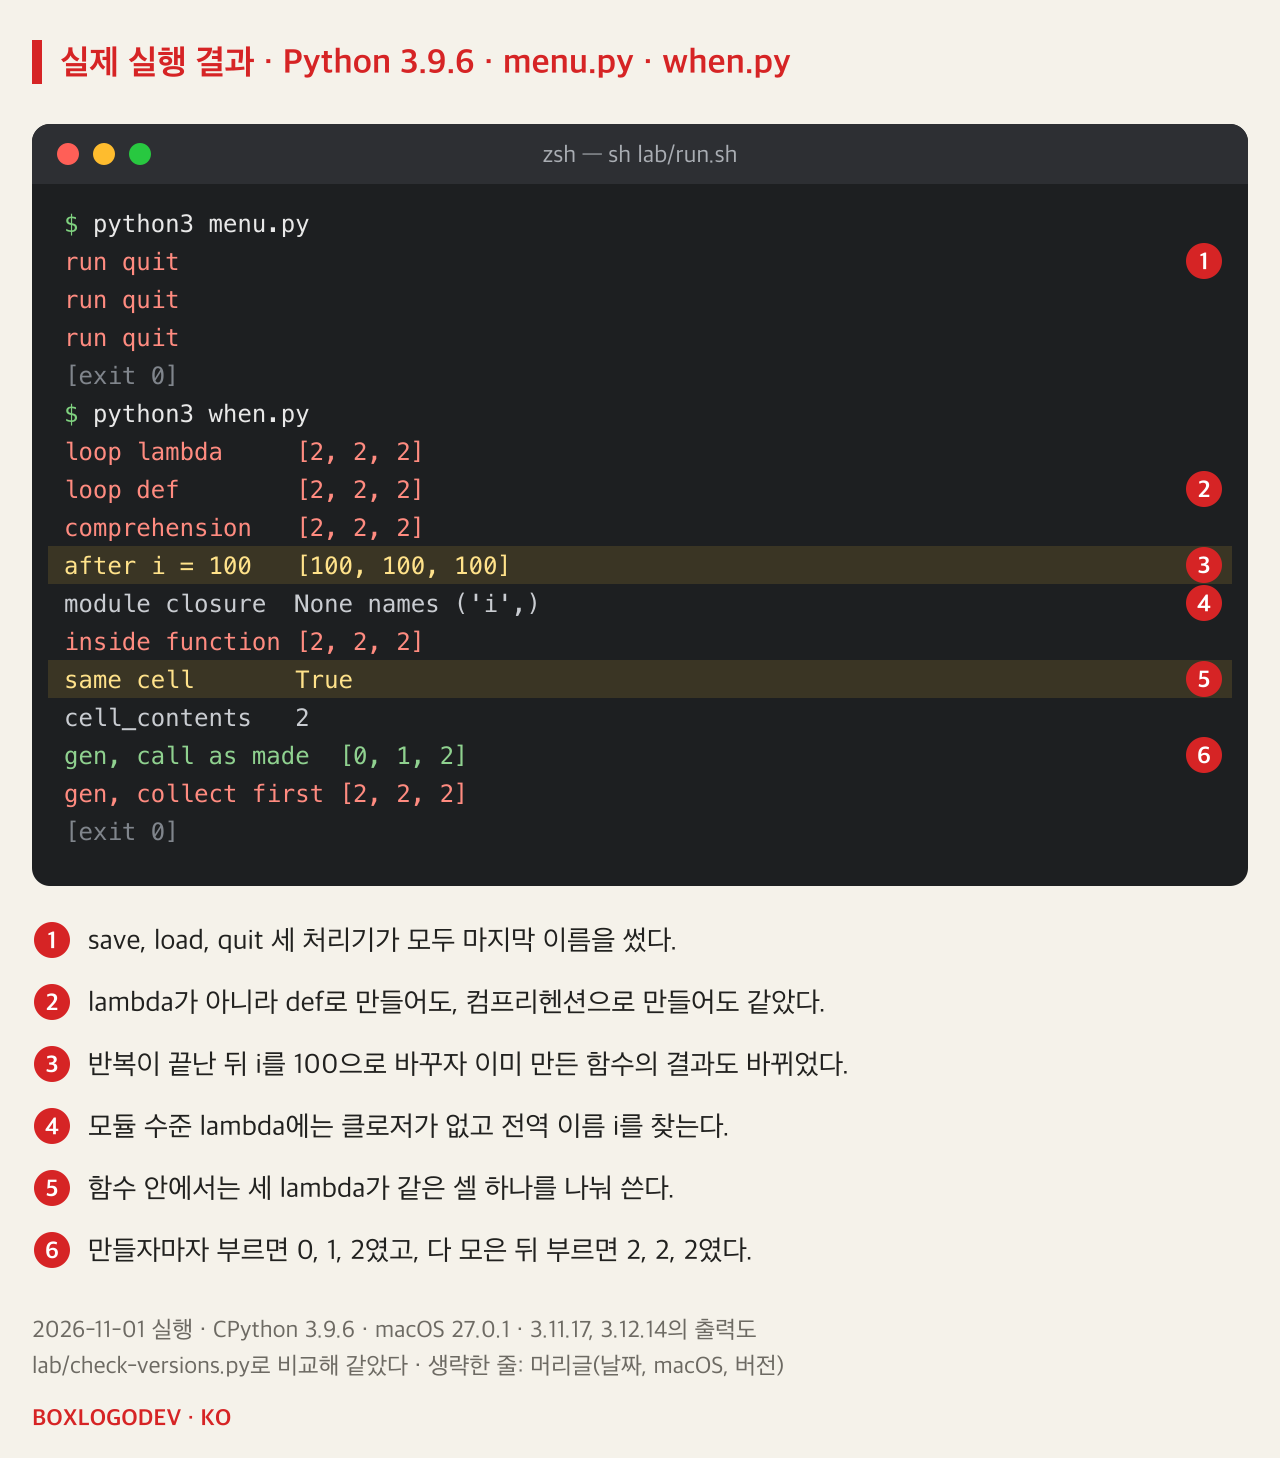
반복마다 새 변수가 생기지 않는 이유도 문서에서 읽을 수 있습니다. 실행 모델 문서가 블록으로 꼽는 것은 모듈, 함수 본문, 클래스 정의이고 for는 이름을 묶는 구문으로 나옵니다. 그러니 반복 몇 번을 돌든 같은 이름에 값을 다시 넣을 뿐입니다. 숫자로 바꾼 when.py에서 lambda는 [2, 2, 2]였고, def로 만들어도 같았습니다. 반복이 끝난 뒤 i = 100을 넣자 이미 만든 함수들이 [100, 100, 100]을 돌려주었습니다. 값을 복사해 두었다면 나올 수 없는 결과입니다.
함수 안에서는 셀 하나를 나눠 쓴다
위 예는 모듈 수준이어서 __closure__가 None이고, lambda는 전역 이름 i를 찾았습니다. 함수 안에서 만들면 모양이 조금 다릅니다.
def build():
    made = []
    for k in range(3):
        made.append(lambda: k)
    return made
이 경우 세 함수의 __closure__에 셀이 들어 있었고, 첫째와 셋째의 셀은 같은 객체(is가 True)였으며 cell_contents는 2였습니다. 컴프리헨션 [lambda: n for n in range(3)]도 [2, 2, 2]였습니다. 언어 문서에 따르면 컴프리헨션은 따로 중첩된 범위에서 실행되는데, 그 범위 안의 n 하나를 모든 함수가 쓴 것으로 읽힙니다. Python 3.12에는 컴프리헨션을 인라인하는 변경(PEP 709)이 들어갔습니다. PEP는 이 경우를 직접 다루지 않고, 3.12.14의 출력은 3.9.6과 같았습니다.
부르는 시점이 답을 가른다는 것은 제너레이터로 확인할 수 있습니다. 같은 식입니다.
gen = (lambda: g for g in range(3))
print("gen, call as made ", [f() for f in gen])
gen = (lambda: g for g in range(3))
print("gen, collect first", [f() for f in list(gen)])
제너레이터는 값을 달라고 할 때 그만큼만 진행합니다. 첫 줄은 함수를 하나 받을 때마다 곧바로 불러 [0, 1, 2]였고, 둘째 줄은 다 받은 뒤에 불러 [2, 2, 2]였습니다.
실행 시점이 끼면 잘못이 숨는다
스레드나 콜백처럼 나중에 불리는 코드에서 이 동작을 만나면 찾기 어려워질 수 있습니다. threads.py는 값을 결과 목록에 넣는 스레드 셋을 반복문에서 시작합니다. 아래는 지연을 넣은 줄과 args로 넘기는 줄입니다.
t = threading.Thread(target=lambda: (time.sleep(0.05), results.append(i)))
t = threading.Thread(target=work, args=(i,))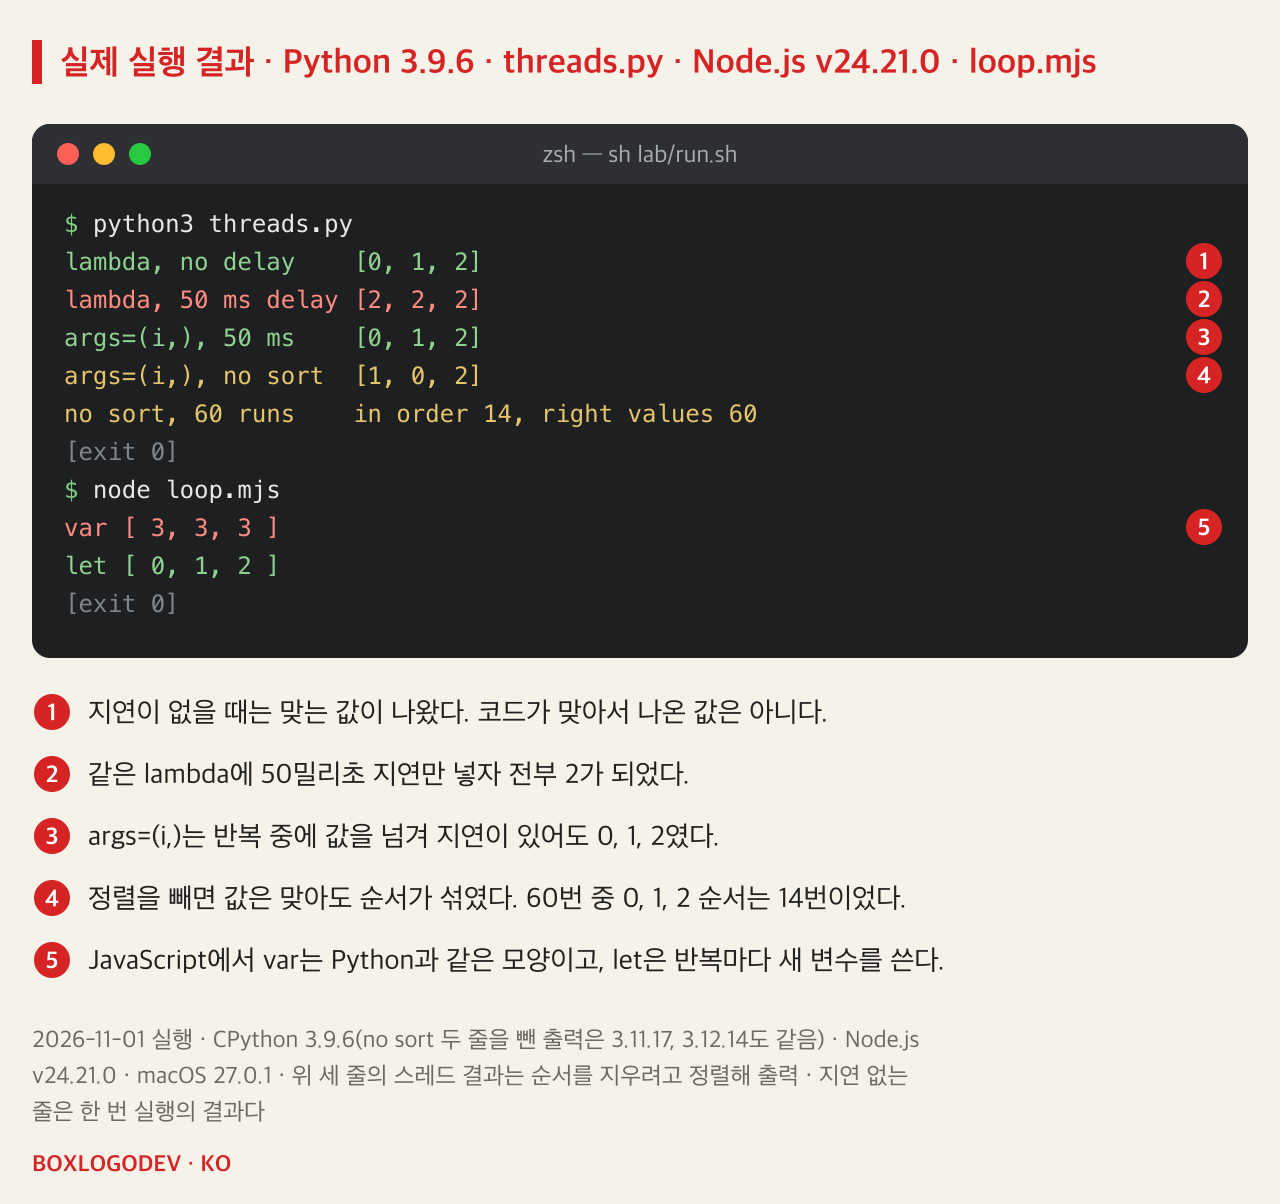
지연이 없는 lambda는 세 버전 모두 [0, 1, 2]였습니다. 스레드가 반복이 넘어가기 전에 i를 읽은 것으로 보이는데, 이는 출력에서 추정한 것이고 각 버전에서 한 번 돌린 결과입니다. 문서의 start() 설명은 별도 스레드에서 실행되도록 마련한다는 것까지만 말합니다. 같은 코드에 50밀리초 지연을 넣자 [2, 2, 2]가 되었습니다. 짧은 작업으로 돌려 본 시험이 통과했다고 안심할 수 없는 이유입니다. args=(i,)는 호출 인자가 반복 중에 계산되어 지연이 있어도 [0, 1, 2]였습니다. 다만 이 출력은 sorted(results)로 정렬한 것이고, 정렬을 빼면 같은 세 값이 스레드가 끝난 순서대로 섞여 나올 수 있습니다. 정렬 없이 60번 돌리자 0, 1, 2 순서로 나온 것은 3.9.6에서 14번, 3.11.17에서 23번, 3.12.14에서 17번이었고, 세 값 자체는 매번 맞았습니다.
JavaScript에 익숙하면 더 헷갈릴 수 있습니다. 같은 모양의 반복에서 var는 [ 3, 3, 3 ], let은 [ 0, 1, 2 ]였습니다. MDN은 for의 let이 반복마다 새 범위와 새 변수를 만든다고 설명합니다. Python의 for는 그 동작이 없어 var 쪽에 가깝다는 것이 글쓴이의 비교입니다.
반복 중의 값을 남기는 세 가지 방법
from functools import partial

by_default = [lambda i=i: i for i in range(3)]

def make(value):
    return lambda: value

by_factory = [make(i) for i in range(3)]

def identity(value):
    return value

by_partial = [partial(identity, i) for i in range(3)]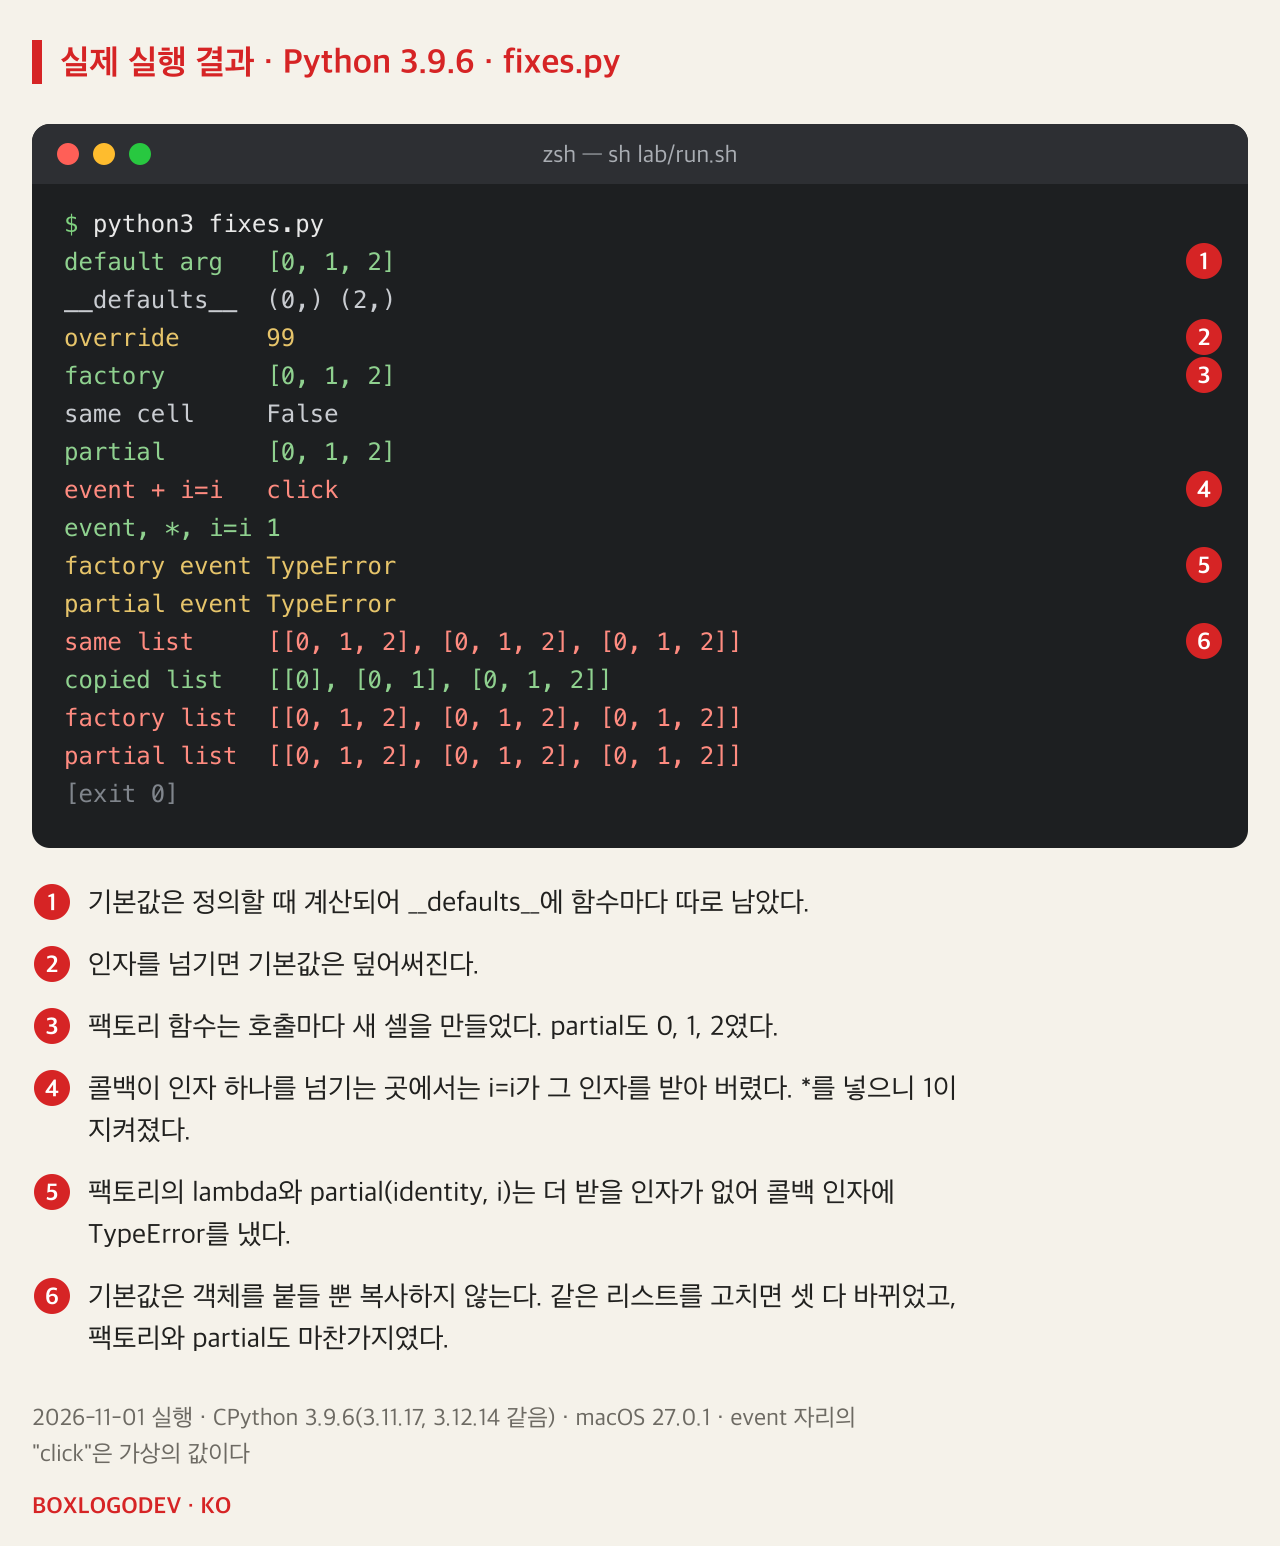
세 방법 모두 [0, 1, 2]였습니다. 기본 인자는 FAQ가 제시하는 방법이고, 언어 문서대로 기본값은 함수 정의가 실행될 때 한 번 계산됩니다. __defaults__에 (0,)과 (2,)가 함수마다 따로 남았습니다. 대신 호출자가 인자를 넘기면 덮어써져 by_default[0](99)는 99였고, 인자 하나를 넘기는 콜백 자리에서는 "click"이 i에 들어갔습니다. lambda event, *, i=i: i로 키워드 전용으로 두자 1이 지켜졌습니다. "click"은 가상의 값입니다.
팩토리 함수는 호출마다 새 셀을 만들었고(is가 False), partial은 이미 있는 함수에 값만 묶었습니다. 인자 하나를 넘기는 콜백 자리에서는 위의 lambda: value와 partial(identity, i)가 더 받을 인자가 없어 TypeError를 냈습니다. 기본 인자와 달리 바로 드러나는 실패입니다. 다만 세 방법이 붙드는 것은 객체이지 복사본이 아닙니다. 같은 리스트 row를 반복에서 고치면서 넘기자 세 방법 모두 [[0, 1, 2], [0, 1, 2], [0, 1, 2]]가 나왔습니다. lambda r=list(row): r처럼 복사해 넘기자 [[0], [0, 1], [0, 1, 2]]가 되었습니다.
개발 노트
반복 중에 값을 붙드는 방법을 고른다
세 방법 모두 반복 중에 값을 계산해 남긴다
기본 인자
lambda event, *, i=i: i- 가장 짧다
- 호출자가 인자를 넘기면 덮어써진다
- 키워드 전용으로 두면 위치 인자를 막는다
팩토리 함수
make(i)- 호출마다 새 셀이 생긴다
- 함수 서명에 여분의 인자가 남지 않는다
functools.partial
partial(identity, i)- 이미 있는 함수에 값만 묶는다
- 여기의 identity는 예시용 함수다
세 방법에 공통인 함정
lambda r=list(row): r- 붙드는 것은 객체이고 복사본이 아니다
- 리스트처럼 바뀌는 값은 복사해 넘긴다
네 칸 모두 2026-11-01 CPython 3.9.6, 3.11.17, 3.12.14에서 실행했다. 고르는 기준은 글쓴이의 정리다.
문서로만 확인한 도구도 있습니다. Ruff에는 flake8-bugbear에서 온 규칙 B023이, Pylint에는 cell-var-from-loop(W0640) 메시지가 있습니다. 둘 다 실행하지 않아 실제 코드에서 얼마나 잡는지는 모릅니다.
코드에서 반복문 안의 lambda와 def를 찾아 "이 함수는 반복이 끝난 뒤에도 불리는가"를 물어 보세요. 그렇다면 반복 변수를 함수 본문에서 읽지 말고 만들 때 넘기세요. 이 점검 방법은 위 실행을 보고 정리한 글쓴이의 판단입니다.
이 기록에 대화를 더해 주세요.
궁금한 점, 다른 접근, 직접 해 본 결과를 나눠 주세요.
로그인 상태 확인 중…
댓글을 불러오는 중…